Anexo · Estadística para Machine Learning (para novatos)
Anexo de apoyo. No es una unidad del curso ni sustituye a la parte de exploración de datos (EDA) que se ve en la Unidad 1. Esta página explica qué significan la media, la desviación, los percentiles, el histograma, el z-score y la correlación, cómo decidir con un test de permutación si una diferencia (como la de un test A/B) es real o ruido, y por qué aparece todo esto en cada modelo. Parte de cero: no hace falta haber dado estadística. Solo se asume saber crear arrays de NumPy y Series de pandas. Los ejemplos se ejecutan con
uv run python(NumPy, pandas, matplotlib y seaborn son dependencias del proyecto).
Contexto y motivación
Cuando un dataset te parezca "solo números" o un modelo te dé una métrica y no sepas qué significa, vuelve aquí. La idea central son tres frases:
- La estadística resume datos: una tabla de 1000 filas se reduce a unos pocos números (media, desviación, percentiles).
- La estadística mide relación: la correlación dice si dos variables "van juntas", pero no que una cause la otra.
- La estadística da la referencia: el modelo más simple es "predecir la media"; todo modelo serio tiene que ganarle a esa trivialidad.
Objetivos observables
Al terminar podrás...
- Describir un dataset con medidas de centro (media, mediana, moda) y de dispersión (desviación típica, IQR) e interpretarlas.
- Distinguir población de muestra, y explicar cuándo se divide entre
n-1. - Leer un histograma y decir si los datos son simétricos o sesgados.
- Calcular e interpretar un z-score, y justificar por qué estandarizamos características en ML.
- Detectar valores atípicos con el IQR y con el z-score, y decidir cómo tratarlos.
- Calcular e interpretar la correlación de Pearson, y separar asociación de causalidad.
- Formular la hipótesis nula de un test A/B y decidir con un test de permutación interpretando el p-valor (y sabiendo lo que no significa).
- Explicar por qué "predecir la media" es el baseline de un modelo.
- Elegir entre estandarizar (z-score) y normalizar (min-max) según el caso.
Cómo comprobarlo: al final hay una práctica de transferencia; si la resuelves, has conseguido todos los objetivos.
Vocabulario mínimo
| Término | Qué significa | En ML |
|---|---|---|
| Población | Todo el conjunto de casos | Todos los datos posibles (casi nunca los tienes) |
| Muestra | Parte observada de la población | Tu dataset |
| Media | Promedio | Centro; baseline trivial |
| Mediana | Valor central (la mitad arriba, la mitad abajo) | Centro robusto ante outliers |
| Moda | Valor más frecuente | Clase mayoritaria |
| Cuartil | Percentiles 25 / 50 / 75 | Cajas del boxplot |
| IQR | Q3 - Q1 |
Dispersión del 50% central |
| Desviación típica | Dispersión media alrededor del centro | Escala de una característica |
| Varianza | Desviación al cuadrado | Suma de errores al cuadrado (MSE) |
| Histograma | Distribución de una variable en barras | Ver la forma de los datos |
| z-score | (x - media) / desviación |
Estandarizar; detectar valores raros |
| Estandarizar | Media 0 y desviación 1 | Modelos basados en distancia (k-NN, k-means) |
| Normalizar | Mínimo 0 y máximo 1 | Acotar a un rango conocido |
| Outlier | Valor que se sale del resto | Error de captura o caso raro; influye en la media |
| Covarianza | Cómo varían dos variables juntas | Dirección de la relación |
| Correlación | Covarianza normalizada, entre -1 y 1 | Asociación lineal; características redundantes |
| Hipótesis nula (H₀) | «El efecto observado es puro azar» | Lo que se pone a prueba en un A/B |
| p-valor | Frecuencia con la que el azar produce una diferencia así o mayor | Umbral típico: 0.05 |
| Test de permutación | Barajar etiquetas para medir qué produce el azar | Decidir entre dos variantes sin fórmulas |
Prerrequisitos
- Saber sumar, restar y dividir.
- Crear arrays en NumPy (
np.array,.shape,.mean()) — lección 1.4 de ML. - Crear una Series de pandas y usar
df.describe()— lección 1.5 · Pandas. - No hace falta haber dado estadística.
- Trae la intuición de una tabla: filas = observaciones, columnas = características.
Orden de los ejemplos
Los bloques se presentan en orden y algunos reutilizan arrays o tablas definidos antes. Para ejecutar uno de forma aislada, copia también sus imports y datos de preparación.
1. Población, muestra y el famoso n-1
Tu dataset es una muestra: un trozo de un conjunto mayor, la población. Los números que calculas en la muestra sirven para estimar los de la población.
| Población | Muestra | |
|---|---|---|
| Qué es | Todo el universo de casos | Los casos que tienes |
| Desviación típica | Se divide entre n |
Se divide entre n-1 |
| ¿Cuándo la tienes? | Casi nunca | Siempre, en un dataset |
En Python hay una trampa fácil:
numpydivide por defecto entren(ddof=0), es decir, como si fuera la población.pandasdivide por defecto entren-1(ddof=1), es decir, como muestra.
import numpy as np
import pandas as pd

notas = pd.Series([5, 7, 6, 8, 4, 9, 6, 7, 5, 7])

print(round(notas.mean(), 2))                 # media
print(round(notas.std(), 2))                  # pandas: divide entre n-1 (muestra)
print(round(np.std(notas), 2))                # numpy: divide entre n (población)
print(round(np.std(notas, ddof=1), 2))        # numpy: forzamos el n-1
Salida esperada:
Con pocos datos la diferencia se nota (1.43 frente a 1.51). Con miles de filas casi
no importa, pero acostúmbrate a saber cuál estás usando. Cuando estimes la
población, usa ddof=1.
2. Centro: media, mediana y moda
- Media: el promedio. Sencilla, pero la arrastran los valores extremos.
- Mediana: el valor que deja la mitad por debajo y la mitad por encima. Robusta.
- Moda: el valor más repetido.
La media de una muestra se escribe así:
→ se suman todos los valores y se divide entre cuántos hay. La mediana no tiene fórmula que memorizar: es el valor que está en el centro cuando ordenas los datos (si hay un número par de datos, el promedio de los dos centrales).
He aquí un ejemplo con un valor sospechoso (un 30 que quizá es un error de
captura):
import numpy as np
import pandas as pd

notas = np.array([5, 7, 6, 8, 4, 9, 6, 7, 5, 30])

print("media:", round(notas.mean(), 2))
print("mediana:", np.median(notas))
print("moda:", pd.Series(notas).mode().tolist())
Salida esperada:
Compruébalo a mano: la suma es 87, así que la media es 87 / 10 = 8.7. Al
ordenar los datos (4, 5, 5, 6, 6, 7, 7, 8, 9, 30), los dos centrales son 6 y
7, luego la mediana es 6.5.
El 30 sube la media a 8.7, pero la mediana sigue en 6.5: ahí está la clave.
Con datos con outliers, la mediana describe mejor el centro; con datos
simétricos, media y mediana casi coinciden.
3. Dispersión: rango, IQR, varianza y desviación típica
El centro no lo dice todo. Dos listas pueden tener la misma media y repartirse muy distinto. La dispersión mide cuánto se alejan los datos del centro.
La varianza es la media de las desviaciones al cuadrado. La diferencia entre población y muestra está solo en el denominador:
donde σ² (población, se divide entre n) y s² (muestra, se divide entre
n-1). La desviación típica es la raíz cuadrada de la varianza, y por eso se
lee en las mismas unidades que el dato:
Ejemplo a mano con [2, 4, 6]:
- Media =
4. - Desviaciones:
-2, 0, 2. - Al cuadrado:
4, 0, 4; la suma es8. - Varianza muestral (dividir entre
n-1 = 2):8 / 2 = 4. - Desviación típica muestral:
√4 = 2. - Si dividieras entre
n = 3(población): varianza8/3 ≈ 2.67y desviación≈ 1.63.
import numpy as np

d = np.array([2.0, 4.0, 6.0])
print("media:", d.mean())
print("varianza (n-1):", round(d.var(ddof=1), 2))
print("desviación (n-1):", round(d.std(ddof=1), 2))
Salida esperada:
La desviación típica se interpreta en las mismas unidades que el dato: si la media de unas notas es 6.4 y la desviación 1.5, la mayoría están "a un paso y medio" de la media. La varianza es su cuadrado: cuando oigas MSE (error cuadrático medio), piensa en "varianza de los errores".
4. Percentiles, cuartiles e IQR, y el boxplot
Los percentiles dividen los datos en 100 partes. Los importantes en EDA son
el 25% (Q1), el 50% (la mediana) y el 75% (Q3). El IQR es
Q3 - Q1 y mide la dispersión del 50% central. El boxplot los dibuja y marca
los valores atípicos.
import numpy as np

notas = np.array([5, 7, 6, 8, 4, 9, 6, 7, 5, 30])
q1, q3 = np.percentile(notas, [25, 75])
iqr = q3 - q1

print("Q1:", q1, "Q3:", q3, "IQR:", iqr)
print("Bigotes (Q1-1.5·IQR, Q3+1.5·IQR):", q1 - 1.5 * iqr, q3 + 1.5 * iqr)
print("Outliers:", notas[(notas < q1 - 1.5 * iqr) | (notas > q3 + 1.5 * iqr)])
Salida esperada:
La "caja" va de Q1 a Q3; la línea central es la mediana; los "bigotes" llegan
hasta el último dato dentro de 1.5·IQR. El 30 queda fuera y por eso se dibuja
como un punto aislado.
Efecto observable (figura, no texto): caja entre 5.25 y 7.75, mediana en 6.5 y el 30 como punto más allá de 11.5, fuera de los bigotes.
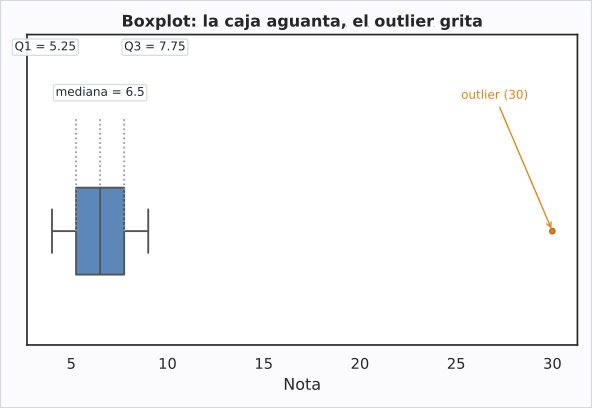
Fíjate en que la caja no se entera del 30: todo el ruido lo marca el punto
aislado, no la caja ni los bigotes.
5. Distribución y forma: el histograma
Un histograma agrupa los valores en barras y muestra la forma de una variable:
- Simétrica: media ≈ mediana; la campana se reparte por igual.
- Sesgada a la derecha: una cola larga hacia valores altos; la media es mayor que la mediana (la arrastra la cola).
- Sesgada a la izquierda: una cola larga hacia valores bajos; la media es menor que la mediana.
import numpy as np
import seaborn as sns

rng = np.random.default_rng(42)
muestras = rng.normal(loc=6.5, scale=1.2, size=100)

print("media:", round(muestras.mean(), 2))
print("mediana:", round(np.median(muestras), 2))
print("desviación:", round(muestras.std(), 2))
sns.histplot(muestras, bins=15)
Salida esperada:
La figura es ≈ simétrica (una "campana"): media y mediana casi iguales. Generamos los datos con una distribución normal de media 6.5 y desviación 1.2; los números de la muestra se le acercan. Pocas barras pueden ocultar la forma y demasiadas la hacen ruidosa: para datos pequeños, 10–15 barras suele ser razonable.
6. La distribución normal y el z-score
La distribución normal (la campana) aparece muchísimo: errores de medida, puntuaciones, medias de muestras... Para comparar valores que vienen de escalas distintas usamos el z-score: cuántas desviaciones típicas se aparta un valor de su media.
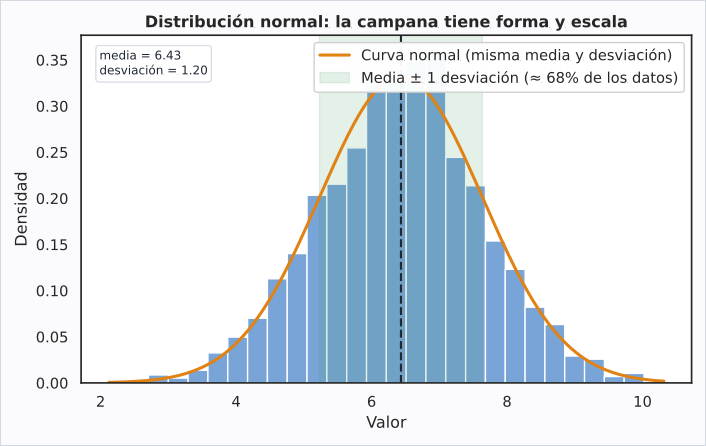
La figura resume la idea: la forma de campana, la curva normal ajustada y la banda de media ± 1 desviación, que en una normal contiene ≈ 68 % de los datos. Esa banda es la que da sentido a "cuántas desviaciones me aparto".
El z-score mide a cuántas desviaciones típicas de la media está un valor:
Ejemplo a mano con [2, 4, 6] (media 4, desviación 2):
x = 6→z = (6-4)/2 = 1(una desviación por encima de la media).x = 2→z = (2-4)/2 = -1(una por debajo).x = 4→z = 0(justo la media).
import numpy as np

datos = np.array([2.0, 4.0, 6.0])
z = (datos - datos.mean()) / datos.std(ddof=1)
print(z)
Salida esperada:
Interpretación: z positivo significa "por encima de la media", negativo "por
debajo"; el valor absoluto da la distancia en desviaciones. Para datos
aproximadamente normales, casi todo cae entre -3 y 3, y un |z| > 3 es raro.
En ML, estandarizar una característica es exactamente aplicar un z-score a
toda su columna.
7. Estandarizar o normalizar
Son dos recetas parecidas pero distintas. Confundirlas pasa factura en ML.
- Estandarizar (z-score): deja la media en 0 y la desviación en 1. Sirve para modelos basados en distancias (k-NN, k-means, regresión penalizada).
- Normalizar (min-max): deja los datos entre 0 y 1. Sirve cuando conoces los límites o quieres acotar un rango (por ejemplo, para imágenes).
Los dos cambios son "celda a celda" sobre una misma columna:
import numpy as np

feature = np.array([0.0, 1.0, 2.0, 3.0])

z = (feature - feature.mean()) / feature.std(ddof=1)
mm = (feature - feature.min()) / (feature.max() - feature.min())

print("z-score:", np.round(z, 2))
print("min-max:", np.round(mm, 2))
print("z media/desv:", round(z.mean(), 2), round(z.std(ddof=1), 2))
Salida esperada:
La regla práctica: distancias → estandariza; rango conocido y acotado → normaliza. Ojo: el min-max es sensible a los outliers (un valor extremo comprime todos los demás hacia el centro); el z-score mantiene las distancias relativas.
8. Valores atípicos (outliers)
Un outlier es un valor que se sale claramente del resto. Puede ser un error de captura, o un caso raro y legítimo. No se borra a lo loco: primero se detecta, después se decide.
Las dos formas más comunes:
- Por IQR: un dato es atípico si está fuera de
[Q1 - 1.5·IQR, Q3 + 1.5·IQR]. - Por z-score: un dato es atípico si
|z| > 2o|z| > 3(según lo estricto que quieras ser).
import numpy as np

notas = np.array([5, 7, 6, 8, 4, 9, 6, 7, 5, 30])
q1, q3 = np.percentile(notas, [25, 75])
iqr = q3 - q1
z = (notas - notas.mean()) / notas.std(ddof=1)

print("Outliers por IQR:", notas[(notas < q1 - 1.5 * iqr) | (notas > q3 + 1.5 * iqr)])
print("Outliers por z (>2):", notas[np.abs(z) > 2])
Salida esperada:
Ambos métodos detectan el 30. ¿Y ahora qué? Si es un error de captura, corrígelo;
si es un caso real, decide si lo mantienes (a veces es justo lo que te interesa).
No lo borres en silencio: la media subió a 8.7 por culpa de ese valor,
mientras la mediana (6.5) no se inmutó. Un outlier también infla la desviación
y puede "aplastar" una normalización min-max.
9. Covarianza y correlación
¿Van dos variables juntas? La covarianza da la dirección (positiva =
crecen juntas; negativa = una sube y la otra baja), pero depende de las unidades:
no se puede comparar entre problemas. La correlación de Pearson divide por las
desviaciones y queda acotada entre -1 y 1:
La covarianza indica la dirección; al dividirla por las desviaciones queda en la escala acotada de la correlación.
import numpy as np

x = np.array([1, 2, 3, 4, 5, 6, 7, 8])
print("perfecta positiva:", round(np.corrcoef(x, 2 * x)[0, 1], 2))
print("perfecta negativa:", round(np.corrcoef(x, -2 * x + 20)[0, 1], 2))

xx = np.array([-3, -2, -1, 0, 1, 2, 3])
yy = xx ** 2
print("parábola (correlación ≈ 0):", round(np.corrcoef(xx, yy)[0, 1], 2))
Salida esperada:
La parábola tiene una relación clarísima y, sin embargo, la correlación de
Pearson da 0. Motivo: la correlación mide asociación lineal, no cualquier
relación. Por eso, ante una relación no lineal, siempre mira un diagrama de
dispersión.
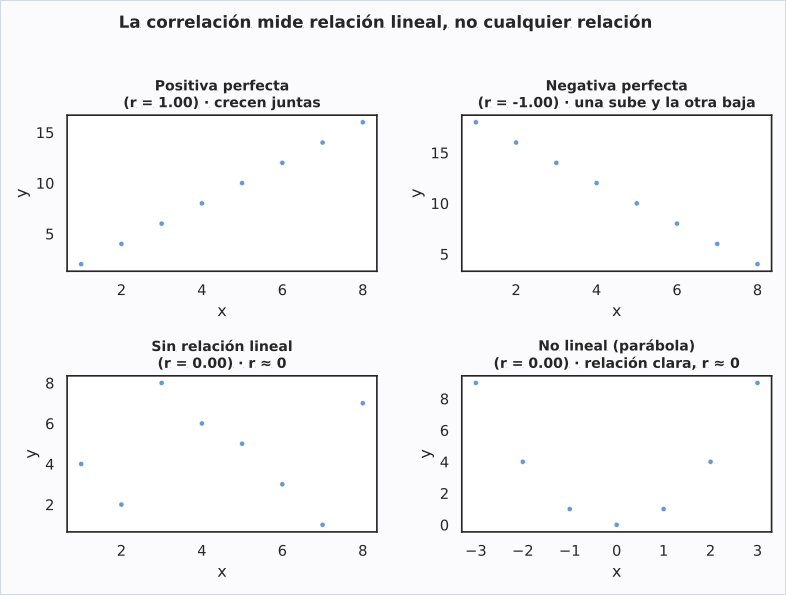
Compáralos: en los dos primeros hay una línea recta perfecta, en el tercero los
puntos no siguen ninguna línea y en el cuarto la relación es obvia pero no es
recta; por eso solo los dos primeros dan un |r| alto.
Ahora, un caso real con pandas y seaborn:
import pandas as pd
import seaborn as sns

datos = pd.DataFrame({
    "horas_estudio": [1, 2, 2, 3, 4, 4, 5, 6, 6, 7],
    "nota": [3, 5, 4, 6, 6, 7, 7, 8, 8, 9],
})

print(datos.corr().round(2))
sns.scatterplot(data=datos, x="horas_estudio", y="nota")
Salida esperada:
Se genera un diagrama de dispersión donde a más horas, más nota. La correlación
0.97 es alta: las dos variables "van juntas".
Correlación no es causalidad
Que dos variables correlacionen no significa que una cause la otra. Las ventas de helados y los ahogamientos suben en verano y correlacionan, pero ninguno provoca al otro: ambos dependen de un tercer factor (la temperatura). En ML, dos características con correlación muy alta aportan información casi redundante, y el modelo no sabe cuál manda (colinealidad).
10. La media como modelo de referencia (baseline)
Antes de lanzarte a un modelo complejo, pregunta: ¿le gano a "predecir siempre la media?" Ese es el baseline más simple. Su error (RMSE) es exactamente la desviación típica poblacional del objetivo.
El RMSE mide el error típico entre lo real y y lo predicho ŷ:
import numpy as np
notas = np.array([5, 7, 6, 8, 4, 9, 6, 7, 5, 7])
media = notas.mean()
baseline = np.full_like(notas, media, dtype=float)
print("media:", round(media, 2))
print("RMSE prediciendo la media:", round(np.sqrt(np.mean((notas - baseline) ** 2)), 2))
print("desviación (población):", round(notas.std(), 2))
Salida esperada:
Ves que el RMSE del baseline (1.43) coincide con la desviación típica (1.43). Ahora compara con un modelo que aprovecha otra variable:
import numpy as np
horas = np.array([1, 2, 2, 3, 4, 4, 5, 6, 6, 7])
nota = np.array([3, 5, 4, 6, 6, 7, 7, 8, 8, 9])
media = nota.mean()
baseline = np.full_like(nota, media, dtype=float)
pendiente, intercept = np.polyfit(horas, nota, 1)
recta = pendiente * horas + intercept
print("Baseline (la media):", round(np.sqrt(np.mean((nota - baseline) ** 2)), 2))
print("Recta ajustada:", round(np.sqrt(np.mean((nota - recta) ** 2)), 2))
Salida esperada:
La recta reduce el error de 1.79 a 0.43: eso es lo que hace un modelo. Por eso
en ML siempre se compara contra un baseline (la media, o la clase mayoritaria
en clasificación). La recta que aparece aquí es una regresión lineal; su
formulación con matrices está en el anexo de álgebra lineal.
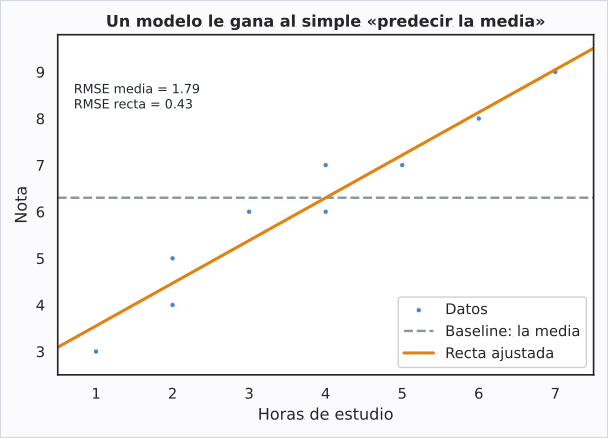
Visualmente: los puntos se alejan de la línea de la media (el baseline) y se agrupan alrededor de la recta. Eso es, en esencia, "aprender de los datos".
11. ¿Real o ruido? Contraste de hipótesis y test de permutación
Hasta aquí la estadística describe (media, dispersión) y relaciona (correlación). Falta la tercera pregunta, la que se hace un analista cada día: ¿lo que veo es un efecto real o puede ser puro azar?
El escenario es el del test A/B de la unidad 3: TechShop prueba dos fichas de producto. La ficha A convirtió 45 de 500 visitas; la ficha B, 66 de 500. La B convierte más (13,2 % frente a 9 %), pero con otros 500 visitantes los números serían otros. ¿Es una diferencia real o es suerte?
Primero se formula la hipótesis nula (H₀), que siempre es «no pasa nada»:
- H₀: las dos fichas convierten igual; la diferencia observada es puro azar.
- H₁: las fichas convierten de forma distinta.
El test de permutación pone H₀ a prueba con una idea muy directa: si H₀ es cierta, las etiquetas A y B no significan nada y se pueden barajar. Se barajan los 1000 resultados, se reparten al azar en dos grupos de 500, se calcula la diferencia y se repite miles de veces. Eso produce la distribución de las diferencias que el azar es capaz de producir:
import numpy as np
rng = np.random.default_rng(42)
# Dos fichas de producto: 500 visitas cada una.
a = np.array([1] * 45 + [0] * 455) # ficha A: 45 compras
b = np.array([1] * 66 + [0] * 434) # ficha B: 66 compras
print("conversión A:", round(a.mean(), 3))
print("conversión B:", round(b.mean(), 3))
diff_obs = b.mean() - a.mean()
print("diferencia observada:", round(diff_obs, 3))
# Si H0 es cierta, la etiqueta A/B es intercambiable: barajamos y repetimos.
junto = np.concatenate([a, b])
n_a = len(a)
N = 10_000
extremos = 0
for _ in range(N):
rng.shuffle(junto)
d = junto[:n_a].mean() - junto[n_a:].mean()
if abs(d) >= abs(diff_obs):
extremos += 1
print("p-valor:", round(extremos / N, 4))
Salida esperada:
El p-valor (0,0431) responde a esta pregunta: si H₀ fuera cierta, ¿con qué frecuencia el azar produciría una diferencia igual o mayor que la observada? En este caso, solo en un 4,3 % de los mundos posibles. Es tan raro que lo razonable es descartar H₀ y concluir que B convierte realmente más. El umbral típico es 0.05: por debajo, la diferencia se declara estadísticamente significativa.
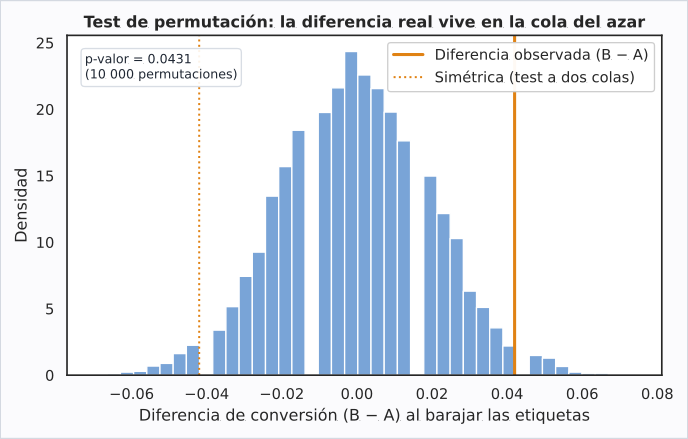
La figura lo resume: la campana es «lo que el azar produce al barajar» y la línea naranja es la diferencia real, bien apartada en la cola. Cuanto más en la cola esté la línea, más pequeño es el p-valor y más raro sería el azar.
Lo que el p-valor NO dice
- No es la probabilidad de que H₀ sea cierta. Es una probabilidad sobre los datos, no sobre la hipótesis.
- No mide la importancia del efecto: una diferencia minúscula puede ser «significativa» con muchas visitas.
- No autoriza a parar el test en cuanto sale favorable (peeking): el tamaño muestral y la duración se fijan antes, como se ve en UD3.5.
Y justo ahí está la última pieza: significación estadística no es relevancia práctica. Un 4,2 % más de conversión puede justificar el cambio de ficha... o no, según lo que cueste mantenerla. El p-valor dice «esto difícilmente es azar»; la decisión la cierra el criterio de negocio. Este es el razonamiento completo que el capítulo 3.5 del módulo de ML aplica en clase.
Errores frecuentes
| Error | Qué pasa | Cómo evitarlo |
|---|---|---|
| Usar la media con datos sesgados | Se va hacia los valores extremos | Mirar mediana y boxplot |
Confundir np.std (ddof=0) con pandas.std() (ddof=1) |
Valores distintos | Pasar ddof explícito o usar una sola librería |
Dividir entre n al estimar la población |
Estimación sesgada | Usar ddof=1 con una muestra |
| Pensar que correlación alta = causalidad | Conclusión falsa | Separar asociación y causa; usar experimentos |
| Usar Pearson en relaciones no lineales | Da ≈ 0 aunque haya relación |
Mirar el scatter; transformar o usar otra métrica |
| Confundir estandarizar y normalizar | Escala incorrecta para el modelo | Distancias → z-score; rango acotado → min-max |
| Normalizar con un outlier | Todo se comprime hacia el centro | Revisar outliers antes de min-max |
| Creer que el z-score exige normalidad exacta | Sobreinterpretar | El z-score es una estandarización; la "normalidad" es una suposición |
| Comparar RMSE sin baseline | No saber si el modelo vale | Calcular siempre el baseline (media / clase mayoritaria) |
| Interpretar el p-valor como «probabilidad de que H₀ sea cierta» | Malentendido clásico | Es una probabilidad sobre los datos, no sobre la hipótesis |
| Parar el test A/B al ver resultado favorable | Falsos positivos (peeking) | Fijar muestral y duración antes de empezar |
| Declarar «B mejor» solo con p < 0.05 | Ignora el tamaño del efecto | Comprobar también la relevancia práctica |
Ejemplo guiado completo
Pongamos todo junto en una mini exploración de un dataset de alumnos:
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
datos = pd.DataFrame({
"horas_estudio": [1, 2, 2, 3, 4, 4, 5, 6, 6, 7],
"nota": [3, 5, 4, 6, 6, 7, 7, 8, 8, 9],
})
print(datos.describe().round(2))
print()
print(datos.corr().round(2))
# ¿Cuánto mejora una recta frente a la media?
y = datos["nota"].to_numpy()
x = datos["horas_estudio"].to_numpy()
rmse_media = np.sqrt(np.mean((y - y.mean()) ** 2))
pendiente, intercept = np.polyfit(x, y, 1)
rmse_recta = np.sqrt(np.mean((y - (pendiente * x + intercept)) ** 2))
print()
print("RMSE media:", round(rmse_media, 2), "| RMSE recta:", round(rmse_recta, 2))
sns.boxplot(data=datos, y="nota")
sns.scatterplot(data=datos, x="horas_estudio", y="nota")
plt.show()
Salida esperada:
horas_estudio nota
count 10.00 10.00
mean 4.00 6.30
std 2.00 1.89
min 1.00 3.00
25% 2.25 5.25
50% 4.00 6.50
75% 5.75 7.75
max 7.00 9.00
               horas_estudio  nota
horas_estudio           1.00  0.97
nota                    0.97  1.00
RMSE media: 1.79 | RMSE recta: 0.43
Se generan dos figuras: un boxplot de la nota y un diagrama de dispersión. Lectura: la nota media es 6.3 con desviación 1.89; la mediana (6.5) y la media están cerca (datos sin sesgo fuerte). Correlación alta entre horas y nota. Y la recta reduce dramáticamente el error frente al baseline de la media.
Práctica de transferencia
Resuelve esto antes de mirar la solución:
- Con
[3, 5, 8, 4, 9], ¿cuál es la media y la mediana? - Con
[2, 4, 6], calcula a mano la varianza muestral y la desviación típica. - Con
[1, 2, 3, 4, 5], ¿qué danp.std()ynp.std(ddof=1)? ¿Cuál usarías para estimar la población? - Si una variable tiene media 10 y desviación 2, ¿qué valor tiene un dato con
z = 2.5? - Añade el 1000 a
[5, 6, 7, 8, 9]. ¿Qué le pasa a la media? ¿Y a la mediana? - Con
x = [1, 2, 3, 4], ¿qué correlación hay cony = [2, 4, 6, 8]? ¿Y cony = x²sobre[-2, -1, 0, 1, 2]? ¿Por qué son distintas? - En un test A/B, la ficha A convierte 40 de 500 y la B, 52 de 500. El p-valor del test de permutación da 0.11. ¿Declararías que B es mejor? ¿Qué significa exactamente ese p-valor?
Soluciones (comprueba después):
- Media
5.8; ordenados3, 4, 5, 8, 9→ mediana5. - Media
4; desviaciones-2, 0, 2; cuadrados4, 0, 4, suma8; varianza8/2 = 4; desviación2. np.std()=1.41(n),np.std(ddof=1)=1.58(n-1). Para estimar la población, usaddof=1.x = 10 + 2.5·2 = 15.[5, 6, 7, 8, 9]→ media7, mediana7. Al añadir el 1000 → media169.5, mediana7.5. La media se dispara; la mediana casi no se mueve.- Con
y = [2, 4, 6, 8]la correlación es1(perfecta y lineal). Cony = x²sobre[-2, -1, 0, 1, 2]la correlación es0(la relación existe pero no es lineal). - No (con el umbral de 0.05). El p-valor 0.11 significa: si ambas fichas convirtieran igual, verías una diferencia así o mayor en un 11 % de los experimentos; no es tan raro como para descartar el azar. Habría que recoger más datos, o decidir con criterio de negocio y prudencia.
Producto evaluable
En tu cuaderno marimo:
- Crea un
DataFramepequeño con dos columnas relacionadas (por ejemplo, horas de estudio y nota de 10 alumnos). - Muestra
df.describe().round(2)y justifica si la media y la mediana están cerca (datos simétricos) o lejos (sesgo u outliers). - Calcula la matriz de correlación y comenta cuál es la relación más fuerte.
- Estandariza una columna con z-score y explica por qué un modelo basado en distancias la necesita.
- En una celda de texto responde: ¿le gana una recta al baseline de la media? Compara los dos RMSE e interpreta el resultado.
Resumen y referencia rápida
| Quiero saber... | Herramienta | Cómo interpretarlo |
|---|---|---|
| El centro | np.mean, np.median, .mode() |
Media sensible a outliers; mediana robusta |
| La dispersión | np.std(ddof=1), IQR |
Desviación: distancia típica al centro |
| La forma | sns.histplot |
Simétrica (media≈mediana) o sesgada |
| Un valor raro | z-score, IQR | Si |z|>2 o fuera de los bigotes |
| Estandarizar | (x - media)/desv |
Media 0, desviación 1 (distancias) |
| Normalizar | (x - min)/(max - min) |
Entre 0 y 1 (rango acotado) |
| Relación lineal | df.corr(), scatter |
-1 a 1; asociación, no causalidad |
| Baseline | np.mean(y) |
El RMSE del baseline ≈ desviación típica |
| Decidir entre dos variantes | Test de permutación | p-valor < 0.05 y diferencia relevante |
Las frases para llevarte: la estadística resume datos, mide relación (no causalidad), da el baseline (la media) que todo modelo debe superar, y con el p-valor de un test de permutación decide si una diferencia es real o ruido: la sorpresa está en los datos, no en la hipótesis.
Referencias
- NumPy ·
np.std - pandas ·
DataFrame.describe - pandas ·
DataFrame.corr - seaborn ·
histplot - seaborn ·
boxplot - seaborn ·
scatterplot - Khan Academy · Estadística y probabilidad (media, mediana, dispersión y regresión, en español)
- 3Blue1Brown · Statistics