1.1 · IA y Aprendizaje Automático
Objetivos. Al terminar este capítulo podrás: definir IA, aprendizaje automático (ML) y aprendizaje profundo (DL) con tus palabras; explicar cómo se relacionan; clasificar un problema real como supervisado, no supervisado o de refuerzo; y distinguir un algoritmo de un modelo.
Evidencia de logro. Dada una lista de problemas reales, los clasificarás correctamente por tipo de aprendizaje y justificarás tu elección en un cuaderno marimo.
Contexto y motivación
Cuando abres Netflix, escribes en el móvil y aparece la palabra que ibas a teclear, o tu banco bloquea un cargo sospechoso, detrás suele haber un sistema que aprendió de los datos en lugar de seguir reglas escritas a mano. Ese es el territorio del aprendizaje automático.
Fíjate en una cosa: en los tres casos nadie programó "si la película es de acción y al usuario le gustó Misión Imposible, entonces recomiéndale…". Eso sería imposible de escribir para millones de usuarios y millones de películas. En su lugar, se dejó que un sistema descubriera esos patrones mirando miles de ejemplos. Esa es la idea central de todo el curso.
Antes de programar nada, necesitamos un mapa del territorio: qué es la IA, dónde encaja el ML y qué tipos de problemas podemos atacar. Este capítulo es ese mapa; los siguientes capítulos te dan las herramientas para moverte por él.
La demo del primer día: el destino del curso
Antes del mapa, una demostración. En la primera sesión se ejecuta en directo el
siguiente programa: entrena un modelo que predice las ventas mensuales de un
producto de TechShop a partir de sus visitas y sus valoraciones. No intentes
entenderlo todavía: la mayoría de las líneas se aprenden en las próximas
semanas; cómo se formula y se evalúa un problema, en la Unidad 3; y qué ocurre
dentro de modelo.fit(...) (la «caja negra»), en la Unidad 4. Hoy solo mira el
destino.
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split

rng = np.random.default_rng(42)
n = 400
visitas = rng.integers(50, 300, n)       # visitas al producto en el mes
valoraciones = rng.integers(1, 6, n)     # nota media de las reseñas (1-5)
ventas = 5 + 0.4 * visitas + 15 * valoraciones + rng.normal(0, 8, n)

X = np.column_stack([visitas, valoraciones])   # características
y = ventas                                     # objetivo

X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=42)

modelo = LinearRegression()              # ← la caja negra: aún no importa cómo funciona
modelo.fit(X_train, y_train)             # «aprender» de los datos...
predicciones = modelo.predict(X_test)    # ...y predecir casos nuevos

rmse_modelo = np.sqrt(np.mean((y_test - predicciones) ** 2))
rmse_baseline = np.sqrt(np.mean((y_test - y_train.mean()) ** 2))
print(f"RMSE del modelo (caja negra): {rmse_modelo:.2f} unidades")
print(f"RMSE del baseline (la media): {rmse_baseline:.2f} unidades")
Salida esperada:
Qué acaba de pasar, sin entrar en detalle:
- Los datos son simulados: las primeras líneas inventan 400 productos cuyas ventas dependen de las visitas y las valoraciones, más un ruido aleatorio. Así sabemos que existe una relación que descubrir.
- Con solo esas dos columnas y las ventas conocidas, la máquina ajustó sola la relación entre ellas: eso es aprender de datos, lo contrario de escribir reglas a mano.
train_test_splitreserva una parte de los productos que el modelo no ve al aprender; con ellos se comprueba si acierta en casos nuevos.- El RMSE (una métrica que formalizaremos en la Unidad 3) mide el tamaño típico del error, en unidades vendidas. El error típico del modelo ronda las 9 unidades; el del baseline trivial, que predice siempre la media, ronda las 35.
- Ese contraste modelo frente a baseline es la pregunta que se repite en todo el curso: ¿merece la pena el modelo frente a lo simple?
Vuelve a este ejemplo cuando llegues a la unidad 4: entonces cada línea te sonará. La diferencia entre «verlo funcionar» y «saberlo construir» es el recorrido de este curso.
Vocabulario
| Término | Significado en el curso |
|---|---|
| IA | Campo que construye sistemas capaces de realizar tareas que normalmente requieren inteligencia humana |
| ML | Parte de la IA donde el sistema aprende patrones a partir de datos, sin reglas explícitas |
| DL | Parte del ML que usa redes neuronales con muchas capas |
| Objetivo | La columna que queremos predecir, la que llamamos y (ej. "spam" o 12000) |
| Etiqueta | El valor conocido del objetivo en un ejemplo de entrenamiento: la «respuesta correcta» (ej. "spam", o 12 000 €) |
| Clase | Cada una de las categorías posibles de un objetivo categórico (ej. "spam" y "no spam") |
| Observación | Una fila de datos: un ejemplo concreto (un correo, un cliente) |
| Característica | Una columna que describe la observación (edad, importe, texto) |
| Algoritmo | La receta que aprende: el procedimiento de entrenamiento |
| Modelo | El resultado del entrenamiento: lo que queda y se usa para predecir |
| Inferencia | El uso del modelo ya entrenado: darle unos datos nuevos y devolver una predicción |
Prerrequisitos
No necesitas saber Machine Learning, pero sí lo básico de Python que se ve en el módulo paralelo de Programación de IA: variables, condicionales, bucles, listas y diccionarios. En la página de la unidad tienes el enlace.
Tampoco hace falta que sepas NumPy o scikit-learn: aquí solo aparecen como «cajas negras» para mostrar a dónde lleva el aprendizaje automático. Lo que importa en este capítulo es la intuición, no las APIs.
1. ¿Qué es la inteligencia artificial?
La inteligencia artificial (IA) es el campo que construye sistemas capaces de realizar tareas que, si las hiciera una persona, diríamos que requieren inteligencia: entender un texto, reconocer una imagen, traducir, planificar o tomar una decisión.
Conviene empezar aclarando qué no es, porque las películas nos han enseñado una imagen equivocada:
- Inteligencia no es conciencia. Un sistema puede ganar al ajedrez o resumir un texto sin "saber" que lo hace. En este curso hablamos de comportamiento inteligente, no de máquinas con sentimientos, intenciones o emociones.
- IA no es "magia" ni "la máquina que lo sabe todo". Son programas que resuelven tareas concretas, a menudo con errores, y siempre diseñados por personas.
Una distinción clásica ayuda a situar el debate:
- IA débil (o estrecha). Resuelve una tarea concreta: traducir, recomendar, detectar spam, reconocer caras. Es la que existe hoy y la que verás en este curso.
- IA fuerte (o general). Sería una máquina con capacidades humanas generales, capaz de razonar sobre cualquier tema. Por ahora es un objetivo de investigación, no una realidad.
El Test de Turing (Alan Turing, 1950) es el experimento histórico que dio origen a la pregunta "¿puede pensar una máquina?": si una persona conversa con una máquina y no puede distinguirla de un humano, la máquina supera la prueba. Es útil como idea fundacional, pero hoy sabemos que imitar una conversación no equivale a entender: un sistema puede engañar a un humano y no comprender nada de lo que dice.
IA en tu día a día
Sin darte cuenta ya convives con IA débil: el corrector del móvil, el filtro de spam del correo, las recomendaciones de música, el desbloqueo facial, los mapas que calculan rutas o el traductor automático. Todos resuelven una tarea concreta y muy bien definida.
2. IA, ML y Deep Learning
La relación entre los tres conceptos es de conjuntos anidados:
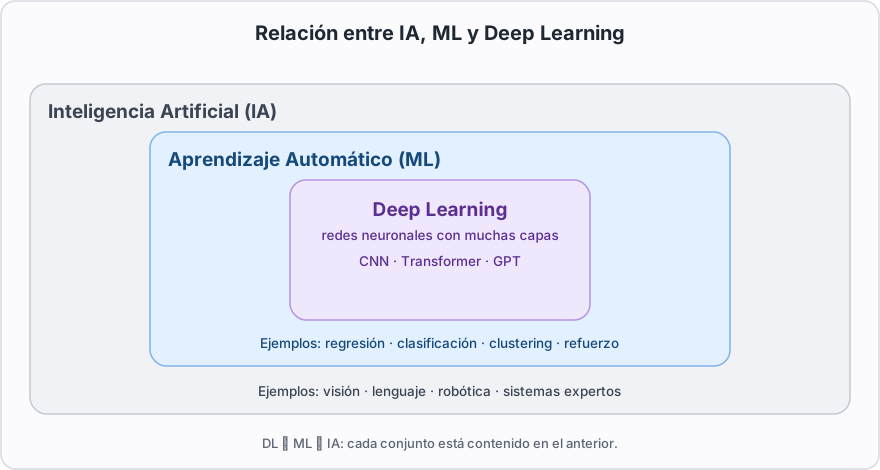
- IA es el campo completo: cualquier sistema con comportamiento inteligente.
- ML es la parte de la IA que, en lugar de programar reglas, deja que el sistema aprenda de los datos.
- DL es la parte del ML que usa redes neuronales profundas (muchas capas).
2.1 Programar reglas vs. aprender de datos
El contraste clave está entre escribir reglas y dejar que aprendan.
Enfoque con reglas (IA clásica). Una persona analiza el problema y escribe cada condición a mano:
# Idea ilustrativa: el humano escribe cada regla.
def es_spam_por_reglas(asunto, remitente):
    if "premio" in asunto.lower() and "gratis" in asunto.lower():
        return True
    if remitente.endswith("@dominio-sospechoso.com"):
        return True
    return False
Esto funciona para casos sencillos, pero se rompe enseguida: los spammers cambian las palabras ("pr3mio", "gr4tis"), aparecen casos nuevos y la lista de reglas crece hasta ser inmantenible. Cada regla nueva puede contradecir a otra.
Enfoque con ML. En lugar de escribir reglas, le damos al sistema muchos ejemplos etiquetados ("estos 10 000 correos son spam, estos otros 10 000 no") y dejamos que él descubra qué los distingue:
# Idea ilustrativa: en ML no escribimos la condición.
# Le damos ejemplos (correo, etiqueta) y el algoritmo aprende el patrón.
ejemplos = [
    ("Gana un premio gratis hoy", "spam"),
    ("Reunión del equipo el lunes", "no spam"),
    # ... miles de ejemplos más
]
# El modelo resultante es la "regla aprendida", que no escribimos a mano.
Qué observar: estos dos bloques ilustran la idea y no producen salida. La función
de reglas devuelve True o False según condiciones escritas por una persona,
mientras que en ML la condición no se escribe: se aprende. El primer
modelo real lo entrenaremos en la Unidad 4, pero la idea ya está aquí:
los datos reemplazan a las reglas escritas a mano.
2.2 Qué significa exactamente "aprender de los datos"
Aprender, en este contexto, significa ajustar unos parámetros internos para que el sistema acierte en los ejemplos que le mostramos y, sobre todo, en ejemplos que no ha visto. Un modelo de ML es, en el fondo, una función que recibe las características de una observación y devuelve una predicción:
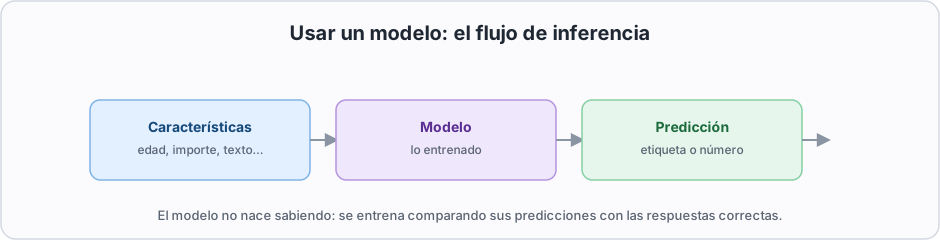
Las características de una observación entran al modelo entrenado y este devuelve la predicción: una etiqueta (clasificación) o un número (regresión).
Ese modelo no nace sabiendo: se entrena comparando sus predicciones con las respuestas correctas y corrigiéndose poco a poco. Lo veremos en detalle en la unidad 4 (cómo se entrena) y en la 3 (cómo se formula y se evalúa).
3. Tipos de aprendizaje
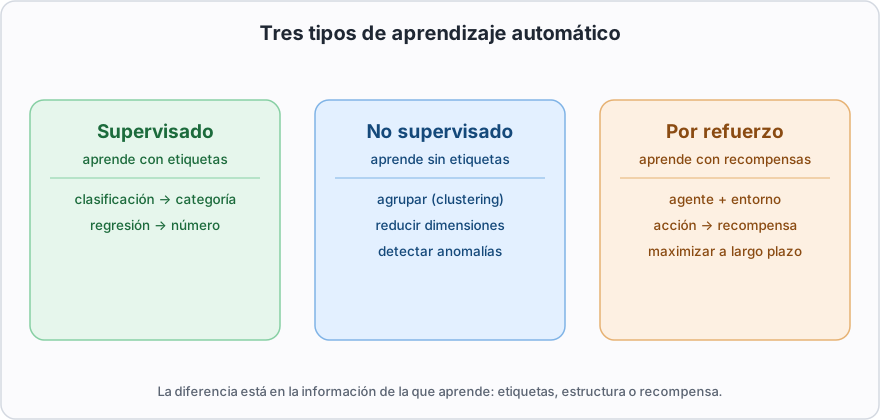
Según la información de la que disponemos, distinguimos tres familias. La diferencia está en qué le damos al sistema para que aprenda:
3.1 Aprendizaje supervisado
Aprendemos con ejemplos etiquetados: cada observación viene con su respuesta correcta (la etiqueta). El objetivo es predecir la etiqueta de observaciones nuevas.
Imagina que queremos predecir si un cliente de TechShop "se dará de baja". Le damos al sistema una tabla donde cada fila es un cliente (edad, ciudad, nº de pedidos…) y una columna final con lo que pasó (se fue / se quedó). El sistema aprende a relacionar las características con la etiqueta.
Dentro del supervisado distinguimos dos problemas según el tipo del objetivo:
- Clasificación: el objetivo es una categoría, y cada categoría posible es una clase. Ej.: ¿este correo es spam o no spam? ¿esta reseña es positiva o negativa? ¿este cliente se dará de baja o no?
- Regresión: el objetivo es un número, así que la etiqueta de cada ejemplo es un valor numérico. Ej.: ¿cuánto valdrá esta casa? ¿cuántas ventas tendremos el mes que viene? ¿qué temperatura hará mañana?
3.2 Aprendizaje no supervisado
Aprendemos sin etiquetas: solo tenemos las observaciones y buscamos estructura en ellas. No hay "respuesta correcta" que predecir; queremos entender cómo se organizan los datos.
- Clustering (agrupamiento): agrupar clientes con comportamientos parecidos (para lanzar campañas distintas a cada grupo).
- Reducción de dimensionalidad: resumir muchas columnas en pocas sin perder demasiada información (para poder visualizar o acelerar otros modelos).
- Detección de anomalías: encontrar observaciones raras (un pedido sospechosamente grande puede ser fraude).
3.3 Aprendizaje por refuerzo
Un agente aprende interactuando con un entorno: realiza acciones y recibe recompensas. El objetivo es elegir la secuencia de acciones que maximiza la recompensa a largo plazo.
La clave aquí es el ensayo y error con recompensa: el agente no recibe la "respuesta correcta" de cada paso (como en supervisado), sino una señal de lo bien o mal que lo ha hecho, y aprende a mejorar. Ej.: enseñar a un robot a caminar, entrenar a un coche autónomo a aparcar, o decidir qué oferta mostrar a cada visitante de TechShop para maximizar clics.
Una tabla para llevarte
| Pregunta | Supervisado | No supervisado | Refuerzo |
|---|---|---|---|
| ¿Qué le damos? | Características + etiqueta | Solo características | Acciones + recompensas |
| ¿Qué queremos? | Predecir la etiqueta | Descubrir estructura | Maximizar recompensa |
| Ejemplo TechShop | ¿Se irá este cliente? | Agrupar clientes | ¿Qué oferta mostrar? |
Híbridos
Existen combinaciones (p. ej. aprendizaje semisupervisado, con pocas etiquetas y muchos datos sin etiquetar, o auto-supervisado, donde la etiqueta se construye a partir del propio dato). Se mencionan en su momento, pero las tres familias anteriores son el mapa principal.
3.4 Variables cuantitativas y categóricas
El tipo de problema depende del tipo de variable que queremos predecir:
- Cuantitativa (numérica): importe, edad, número de ventas → regresión.
- Categórica: color, ciudad, "spam/no spam" → clasificación.
Esta distinción parece trivial, pero condiciona todo lo que viene después: las métricas para evaluar, los algoritmos que elegimos y hasta cómo preparamos los datos. Por eso la repetiremos en cada unidad.
4. Algoritmo vs. modelo
Es la distinción que más confunde al principio, y es importante porque aparecerá en todo el curso:
- El algoritmo es la receta: el procedimiento que aprende a partir de los datos.
- El modelo es el resultado: lo que queda cuando el algoritmo termina, y lo que usamos para predecir.
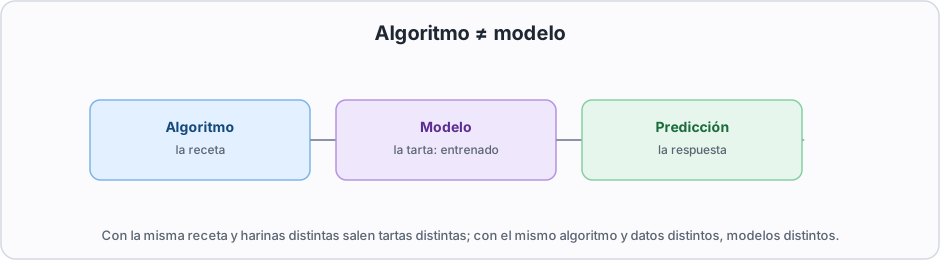
El algoritmo (la receta) entrena con datos y produce el modelo (la tarta); el modelo entrenado es lo que se usa para producir predicciones.
Una analogía: la receta de una tarta es el algoritmo; la tarta que sale del horno es el modelo. Con la misma receta y harinas distintas salen tartas distintas; con el mismo algoritmo y datos distintos salen modelos distintos.
Por qué importa en la práctica
El algoritmo se escribe una vez y es general; el modelo se entrena con unos datos concretos y es lo que guardas en disco para usarlo después. Cuando decimos "he entrenado un modelo de regresión", queremos decir: "he ejecutado el algoritmo de regresión con mis datos y me ha devuelto unos parámetros que ahora predicen". Distinguirlo te evitará frases confusas como "voy a usar un algoritmo para predecir" (en realidad usas un modelo).
4.1 El ciclo de construcción de un modelo
- Formular el problema (¿qué predecimos y con qué datos?).
- Preparar los datos (limpiar y transformar).
- Entrenar (el algoritmo ajusta sus parámetros con los datos).
- Evaluar (medir lo bien que predice con datos que no vio).
- Usar (poner el modelo a decidir en producción).
Este ciclo se retoma en los capítulos 1.2 y en las unidades 2 y 3. Fíjate en que entrenar es solo uno de los cinco pasos; los principiantes suelen obsesionarse con el paso 3 y descuidar los otros cuatro, que son donde fracasan la mayoría de proyectos reales.
5. Mapa de algoritmos
No vamos a estudiarlos todavía (eso llega en las unidades 4–7), pero conviene saber que existen familias con fortalezas distintas:
- Lineales y probabilísticos: regresión lineal, regresión logística. Sencillos, rápidos y fáciles de interpretar.
- Basados en proximidad: k-NN. Comparan la observación nueva con las más parecidas.
- Árboles y ensembles: árboles de decisión, Random Forest, Gradient Boosting. Muy usados con datos tabulares.
- Redes neuronales: MLP, CNN, Transformer (Deep Learning). Dominan imagen, texto y audio.
- Por refuerzo: Q-learning y sus variantes profundas.
La regla del curso: primero un modelo sencillo y un baseline; luego, solo si hace falta, uno más complejo. Un modelo más grande no es automáticamente mejor: añade coste, riesgo de sobreajuste y dificultad de explicar. Un buen profesional no empieza por el algoritmo más potente, sino por el más simple que resuelve el problema.
6. Tendencias recientes
- Deep Learning domina tareas con datos masivos y no estructurados (imagen, texto, audio). Lo veremos en la Unidad 6.
- IA generativa crea contenido nuevo (texto, imagen, código, audio). Son modelos entrenados sobre cantidades enormes de datos que aprenden a "continuar" o "generar" contenido plausible. Su uso aplicado (APIs, RAG, agentes) corresponde al módulo de Programación de IA; aquí nos quedamos con la idea conceptual.
- Ética y regulación. Los sistemas aprenden de datos reales y, por tanto, heredan sus sesgos. Por eso la transparencia, la explicabilidad y normas como el Reglamento Europeo de IA (AI Act) no son un apéndice: son criterios que aplicaremos de forma transversal en todo el curso. Un modelo que acierta mucho pero discrimina, es opaco o no se puede auditar no es un buen modelo.
Errores frecuentes
- Confundir IA con "máquinas conscientes". La IA actual es débil y especializada; no tiene conciencia ni intenciones.
- Pensar que todo lo que usa datos es ML. Una hoja de cálculo con fórmulas usa datos, pero no aprende de ellos: las reglas las escribe la persona.
- Creer que "no supervisado" significa "sin intervención humana". Significa "sin etiquetas": el humano sigue diseñando el experimento, eligiendo los datos e interpretando el resultado.
- Confundir algoritmo y modelo. El algoritmo entrena; el modelo predice.
- Suponer que más complejo = mejor. Un baseline sencillo primero, siempre.
- Saltarse la formulación del problema. Sin un objetivo claro (¿qué predigo y para qué?), ningún algoritmo te salvará.
Práctica de transferencia
Clasifica cada caso indicando: (a) si es ML o no, (b) el tipo de aprendizaje (supervisado, no supervisado, refuerzo) y © si es clasificación o regresión cuando sea supervisado. Justifica en una frase.
- Predecir el precio de una casa a partir de su superficie, zona y año.
- Agrupar los clientes de TechShop en segmentos con comportamientos parecidos.
- Un coche autónomo que aprende a aparcar mediante prueba y error con recompensas.
- Detectar si una reseña de TechShop es positiva o negativa.
- Calcular la media de ventas del mes con una fórmula de Excel.
- Encontrar compras muy distintas al resto (posible fraude).
- Estimar cuántas unidades se venderán de un producto el mes próximo.
- Decidir qué banner mostrar a cada visitante para maximizar clics.
Qué debes justificar: para cada caso, qué se da al sistema (¿hay una respuesta correcta conocida para cada ejemplo?, ¿hay recompensas?) y, si es supervisado, de qué tipo es el objetivo (categoría o número). Al menos un caso de la lista no es ML: explica por qué.
Producto evaluable
Crea un cuaderno marimo llamado 01_tipos_aprendizaje.py con:
- Una celda Markdown con tu propia definición de IA, ML y DL (dos o tres frases, sin copiar).
-
Una celda Python con la clasificación de los 8 casos anteriores. Copia esta estructura y complétala (las listas y las tuplas se estudian en la Unidad 1 de Programación de IA; aquí basta con seguir el modelo):
-
Una celda Markdown final con un ejemplo propio de cada tipo de aprendizaje (que no esté en la lista anterior).
Formato de entrega: cuaderno marimo ejecutado, con conclusiones al final.
Resumen y referencia rápida
| Concepto | Resumen |
|---|---|
| IA | Sistemas con comportamiento inteligente (sin exigir conciencia) |
| ML | Aprende patrones de los datos en lugar de seguir reglas escritas |
| DL | ML con redes neuronales profundas |
| Supervisado | Con etiquetas → clasificación (categoría) o regresión (número) |
| No supervisado | Sin etiquetas → agrupar, reducir, detectar anomalías |
| Refuerzo | Agente + entorno + recompensa, aprendiendo a decidir |
| Algoritmo vs. modelo | El algoritmo entrena; el modelo es el resultado que predice |
| Regla práctica | Baseline primero, complejidad solo si se justifica |
Siguiente: 1.2 · Data Science y ciclo de vida.