1.2 · Data Science y ciclo de vida
Objetivos. Al terminar este capítulo podrás: nombrar los tres pilares de la ciencia de datos; describir el ciclo de vida de un proyecto (recolección, limpieza, transformación, exploración, modelado y comunicación); calcular e interpretar medidas descriptivas básicas; y explicar por qué correlación no implica causalidad.
Evidencia de logro. Dado un conjunto pequeño de datos, calcularás su media, mediana y correlación, y situarás cada tarea del proyecto dentro del ciclo de vida, justificando el orden.
Contexto y motivación
Un proyecto de datos rara vez fracasa por el algoritmo: fracasa porque el problema estaba mal definido o los datos estaban sucios. Piénsalo como cocinar: puedes tener la mejor sartén del mundo, pero si los ingredientes están en mal estado, el plato sale mal. En ML los "ingredientes" son los datos.
Este capítulo te da la visión de conjunto que necesitas para no perderte cuando, en los próximos capítulos, programes con NumPy, Pandas y SQL. Antes de escribir una línea de código hay que saber qué estamos haciendo y en qué orden.
Vocabulario
| Término | Significado |
|---|---|
| Ciencia de datos | Disciplina que extrae conocimiento de los datos combinando estadística, programación y dominio |
| Población | Conjunto completo de elementos que nos interesa estudiar |
| Muestra | Subconjunto de la población que realmente observamos |
| Media | Valor central (suma dividida entre el número de valores) |
| Mediana | Valor que queda en el centro al ordenar los datos |
| Desviación típica | Cuánto se dispersan los datos alrededor de la media |
| Correlación | Grado de asociación lineal entre dos variables (no implica causalidad) |
| EDA | Análisis exploratorio de datos (Exploratory Data Analysis) |
Prerrequisitos
Haber leído 1.1 · IA y Aprendizaje Automático.
1. Los tres pilares
La ciencia de datos se apoya en tres patas; si falta una, el proyecto cojea:
- Estadística y matemáticas: para medir, comparar y no engañarnos con los números. Sin esto, cualquier gráfico o modelo es un espejismo.
- Programación y tecnología: para cargar, transformar y automatizar el análisis (Python, SQL, NumPy, Pandas…). Es lo que convierte las ideas en resultados reproducibles.
- Conocimiento del dominio: para saber qué preguntas merece la pena hacer y qué significan los datos.
El dominio importa
Un modelo que predice "rotación de clientes" es inútil si nadie sabe qué es "rotación" en TechShop (¿un cliente que no compra en 30 días? ¿uno que cierra la cuenta?). La técnica sin contexto produce números bonitos y decisiones malas. Por eso todo el curso gira en torno a un caso concreto (TechShop) en lugar de datasets abstractos.
2. Estadística descriptiva mínima
Antes de modelar, describimos los datos. La estadística descriptiva responde a tres preguntas: ¿dónde está el centro de los datos? ¿cuánto se dispersan? ¿cómo se relacionan dos variables? Veámoslo con un ejemplo de TechShop.
No te preocupes si todavía no conoces NumPy ni pandas: se estudian a fondo en
1.4 y 1.5. De momento basta con leer el código
así: np.array([...]) convierte una lista de números en un array de NumPy,
que sabe calcular estadísticas (visitas.mean() es la media), y
pd.DataFrame({...}) construye una tabla con una columna por variable.
import numpy as np
import pandas as pd

# TechShop: visitas a la web y ventas de una semana (datos inventados).
visitas = np.array([120, 150, 90, 200, 175, 80, 210])
ventas = np.array([12, 18, 8, 25, 20, 7, 27])

print("media visitas:", visitas.mean())
print("mediana visitas:", np.median(visitas))
print("rango visitas:", visitas.max() - visitas.min())
print("desviación típica ventas:", round(ventas.std(ddof=1), 2))

tabla = pd.DataFrame({"visitas": visitas, "ventas": ventas})
print()
print(tabla.corr(numeric_only=True))
Salida esperada:
media visitas: 146.42857142857142
mediana visitas: 150.0
rango visitas: 130
desviación típica ventas: 7.95

          visitas    ventas
visitas  1.000000  0.996432
ventas   0.996432  1.000000
Interpretemos cada número (interpretar es tan importante como calcular):
- Media (146,4 visitas). Es el centro "aritmético": repartimos el total a partes iguales entre los 7 días.
- Mediana (150). Si ordenamos los días por visitas, el del medio tiene 150. La mediana es robusta: un día con 10 000 visitas dispararía la media pero apenas movería la mediana. Por eso, ante datos con valores extremos, la mediana suele describir mejor "un día típico".
- Rango (130 = 210 − 80). Es la dispersión más simple: distancia entre el máximo y el mínimo. Es útil, pero se deja engañar por un único valor extremo.
- Desviación típica (7,95 ventas). Mide, aproximadamente, cuánto se alejan los valores de su media, en las mismas unidades que los datos. Una desviación pequeña = datos apretados alrededor de la media; grande = muy dispersos.
- Tabla de correlaciones. Cada celda cruza dos variables. La diagonal vale
siempre
1, porque cada variable se correlaciona perfectamente consigo misma; el dato interesante es el de fuera de la diagonal,0.996432, que aparece dos veces porque la tabla es simétrica.
¿Por qué ddof=1?
En ventas.std(ddof=1) usamos ddof=1 (el estándar en estadística cuando
trabajamos con una muestra y no con toda la población). Pandas y muchas
librerías usan ese ajuste por defecto; NumPy, en cambio, usa ddof=0 por
defecto. Por eso es bueno declararlo explícitamente cuando importe. No
memorices el detalle ahora: solo recuerda que "muestra vs. población" cambia
ligeramente la fórmula, y lo retomaremos en la Unidad 3.
Pandas resume todo esto de un vistazo con describe():
Salida esperada:
       visitas  ventas
count     7.00    7.00
mean    146.43   16.71
std      51.70    7.95
min      80.00    7.00
25%     105.00   10.00
50%     150.00   18.00
75%     187.50   22.50
max     210.00   27.00
Cada fila es una medida y cada columna una variable. count es el número de
valores, mean la media y std la desviación típica; 50% es la mediana, y
25% y 75% son los cuartiles (los veremos en el capítulo de SQL).
2.1 Correlación: asociación, no causalidad
La correlación entre visitas y ventas es 0,996: muy alta y positiva (cuando una sube, la otra sube). La correlación va de −1 a +1:
- +1: relación lineal perfecta y directa (suben juntas).
- 0: sin relación lineal aparente.
- −1: relación lineal perfecta e inversa (una sube, la otra baja).
Correlación no es causalidad
Que visitas y ventas se muevan juntas no demuestra que más visitas causen más ventas (aunque aquí sea plausible). Podría haber una tercera variable — una campaña de publicidad, una rebaja — que sube ambas a la vez. Confundir "se mueven juntas" con "una causa la otra" es uno de los errores más caros del análisis de datos. La causalidad requiere experimentos o técnicas específicas, y la incertidumbre se trata con rigor en la Unidad 3.
3. El ciclo de vida de un proyecto
Todo proyecto de datos, grande o pequeño, recorre seis pasos. El orden importa: no puedes modelar datos que aún no has limpiado.
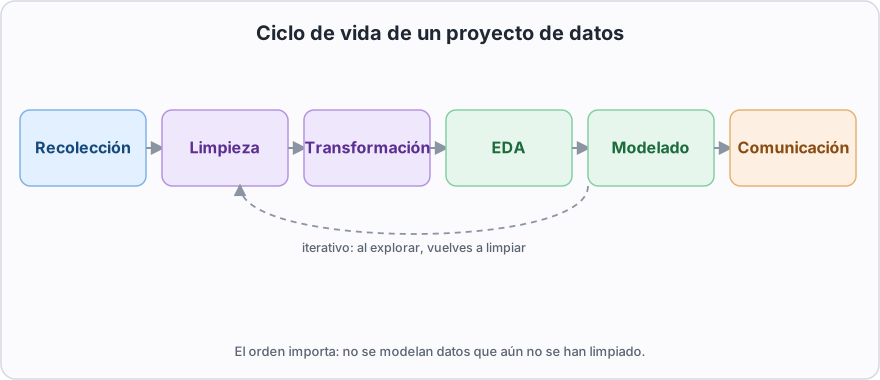
Sigamos el ejemplo de TechShop ("¿qué productos deberíamos promocionar?") paso a paso para entender qué ocurre en cada uno:
- Recolección: obtener los datos. En TechShop: descargar el CSV de pedidos, leer la base de datos de clientes, consultar la API de la tienda online.
- Limpieza: corregir errores. Eliminar pedidos duplicados, arreglar fechas con formato raro, decidir qué hacer con importes vacíos.
- Transformación: crear variables útiles. Calcular
importe_total =
   unidades × precio
, agrupar las fechas por semana, codificar la categoría. - Exploración (EDA): visualizar y resumir para entender. Dibujar las ventas por categoría, detectar que "audio" solo se vende los fines de semana, etc.
- Modelado: entrenar y evaluar un modelo. Predecir qué producto es probable que cada cliente compre el mes que viene.
- Comunicación: interpretar y presentar. Explicar al equipo de marketing qué productos promocionar, con qué confianza y por qué.
En esta unidad nos centramos en los pasos 1 a 4 (la capa de datos). El modelado llega en las unidades 3–4 y la comunicación es un hilo que recorre todo el curso.
No es un camino de ida
El ciclo es iterativo: al explorar (paso 4) descubres datos sucios y vuelves a limpiar (paso 2); al modelar (paso 5) te das cuenta de que necesitas una variable nueva y vuelves a transformar (paso 3). Eso es normal y deseable, no un fallo. Los principiantes tienden a querer recorrerlo una sola vez en línea recta, y por eso se frustran.
4. Python en ciencia de datos
Python es el idioma del curso por cuatro razones:
- Sintaxis clara: se lee casi como pseudocódigo, lo que facilita centrarte en la idea y no en la ceremonia del lenguaje.
- Ecosistema rico: NumPy (arrays), Pandas (tablas), Matplotlib/Seaborn (gráficos), scikit-learn (ML). Son piezas que encajan entre sí.
- Comunidad: abundan ejemplos, respuestas y herramientas; casi cualquier problema ya lo ha resuelto alguien antes.
- Rendimiento con NumPy: las operaciones sobre arrays se ejecutan en C por debajo y son mucho más rápidas que los bucles de Python puro.
En el capítulo 1.4 · NumPy medirás esa diferencia de rendimiento con tus propias manos, comparando un bucle de Python con una operación vectorizada.
5. Aplicaciones reales (un vistazo)
- Salud: detección temprana de enfermedades, predicción de brotes epidémicos.
- Finanzas: detección de fraude en tiempo real, scoring de crédito.
- Entretenimiento: recomendaciones (Netflix, Spotify), análisis de audiencia.
- Transporte: optimización de rutas (Uber, empresas de reparto).
- Industria: mantenimiento predictivo de máquinas (avisar antes de que se averíen).
Fíjate en que, aunque los dominios no tienen nada que ver, el patrón es el mismo en todos: datos → limpieza → transformación → exploración → modelo → decisión. Por eso, aprender bien el ciclo una vez te sirve para cualquier sector.
Errores frecuentes
- Saltarse la exploración y lanzarse a modelar. Primero entiende los datos; los modelos no arreglan datos que no entiendes.
- Confundir correlación con causalidad.
- Usar la media cuando hay valores extremos sin compararla con la mediana.
- Tratar el ciclo como una receta lineal rígida en vez de iterar.
- Creer que más datos es siempre mejor sin preguntarse si son representativos y de calidad.
Práctica de transferencia
Con estos datos de TechShop:
pedidos = [3, 5, 2, 8, 6, 4, 9]      # pedidos diarios de una semana
devoluciones = [0, 1, 0, 2, 1, 1, 2] # devoluciones diarias
Para calcular, convierte primero las listas en arrays (np.array(pedidos)) o en
una tabla (pd.DataFrame({"pedidos": pedidos, "devoluciones": devoluciones})),
siguiendo el ejemplo del apartado 2.
- Calcula media y mediana de
pedidos. ¿Cuál describe mejor un día "típico"? - Calcula el rango de
devoluciones. - Calcula la correlación entre
pedidosydevolucionesy explica qué significa (sin afirmar causalidad). - Asigna cada una de estas tareas a un paso del ciclo de vida: "eliminar pedidos duplicados", "dibujar ventas por día", "entrenar un modelo que predice ventas", "leer el CSV de pedidos", "crear la columna importe_total = unidades × precio".
Qué debes comprobar: que la media de pedidos es 5.285714... y la mediana
5.0; si obtienes otra cosa, revisa que has copiado los siete valores.
Producto evaluable
Amplía el cuaderno 01_tipos_aprendizaje.py con una sección nueva:
- Una celda con el cálculo de media, mediana y correlación del ejercicio anterior (con su interpretación en Markdown).
- Una celda Markdown que enumere los seis pasos del ciclo y asocie cada tarea del punto 4.
Formato de entrega: cuaderno marimo ejecutado, con conclusiones al final.
Resumen y referencia rápida
| Concepto | Resumen |
|---|---|
| Tres pilares | Estadística, programación y dominio |
| Media vs. mediana | La mediana resiste mejor los valores extremos |
| Desviación típica | Dispersión alrededor de la media |
| Correlación | Asociación (−1 a +1), no causalidad |
| Ciclo de vida | Recolección → limpieza → transformación → EDA → modelado → comunicación |
| Iteración | Los pasos se repiten, no se recorren una sola vez |
Siguiente: 1.3 · Convenciones y reproducibilidad.