Unidad 1 · Fundamentos de IA, Data Science y datos
Esta unidad abre el módulo de Aprendizaje Automático. Antes de entrenar ningún modelo hay que dominar la capa de datos: entender qué es el aprendizaje automático, situarlo dentro de un proyecto de datos y manejar arrays, tablas y bases de datos con las herramientas del curso.
La unidad arranca con una demo de destino: en la primera sesión se entrena en directo un modelo mínimo, tratándolo como caja negra, para que veas ya en la semana 1 el destino del curso (lo que sabrás construir al final) antes de empezar con los fundamentos.
Objetivos de la unidad
Al terminar esta unidad, sabrás:
- Explicar la diferencia entre inteligencia artificial, aprendizaje automático y aprendizaje profundo, y clasificar un problema según el tipo de aprendizaje que necesita.
- Describir el ciclo de vida de un proyecto de datos y situar cada tarea (recolección, limpieza, transformación, exploración, modelado y comunicación) en su lugar.
- Aplicar las convenciones del curso: vocabulario común, cuadernos marimo, control de versiones y reproducción de resultados.
- Crear e inspeccionar arrays con NumPy: indexación, máscaras booleanas, estadísticas, números aleatorios, broadcasting y operaciones matriciales.
- Cargar, limpiar, filtrar, agrupar y combinar tablas con Pandas 3.x.
- Consultar y combinar datos con SQL (SQLite) e integrar los resultados con Pandas.
- Elegir y usar Parquet, Polars y DuckDB cuando el volumen de datos crece.
Evidencia de logro
Al final de la unidad deberás ser capaz de explicar dónde encaja el ML en un
proyecto de datos, cargar e inspeccionar datos, filtrar y resumir valores
numéricos con NumPy, limpiar y combinar tablas con Pandas y consultar datos con
SQL para dejarlos listos para el análisis. La evidencia se reparte entre el
portfolio de cada bloque y la práctica final: 05_datos_a_escala.py demuestra
el uso de Parquet, Polars y DuckDB, mientras que 06_integracion_ud1.py conecta
NumPy, Pandas y SQL sin introducir herramientas nuevas.
Prerrequisitos
Para seguir la unidad con fluidez necesitas manejar variables, condicionales, bucles y colecciones básicas de Python, además de tener preparado el entorno de trabajo.
Ese material está en la Unidad 1 de Programación de IA, que se imparte en paralelo. No necesitas conocer nada de Machine Learning ni de estadística avanzada: esta unidad empieza desde los conceptos y las herramientas.
Si el bloque de Python todavía se te resiste, la página Qué volver a mirar cuando algo no cuadra te dice qué repasar antes de seguir.
Caso conductor: TechShop
Todos los ejemplos giran en torno a TechShop, una tienda online ficticia con datos de:
- ventas (pedidos, importes, fechas),
- clientes (datos de contacto, segmento, ciudad),
- productos (nombre, categoría, precio),
- reseñas (puntuación y comentario de cada producto).
A lo largo de la unidad crearás tablas de TechShop desde cero, las limpiarás, las consultarás con SQL y las explorarás con Pandas. Ese mismo conjunto de datos te acompañará en las unidades siguientes (preparación, modelado y evaluación).
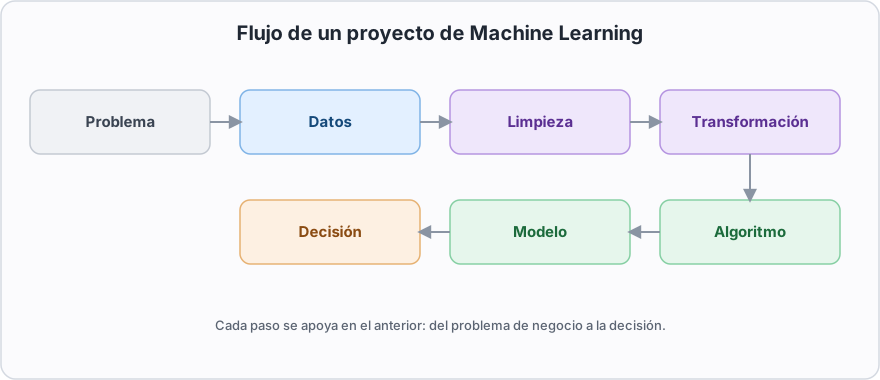
El flujo de un proyecto de ML: del problema de negocio a la decisión. En esta unidad trabajamos los tres primeros pasos (problema, datos y transformación).
Capítulos
| Capítulo | Contenido | Horas |
|---|---|---|
| 1.1 · IA y Aprendizaje Automático | Demo de destino (un primer modelo como caja negra); de la IA al ML: tipos de aprendizaje, algoritmo vs. modelo, tendencias | 3 |
| 1.2 · Data Science y ciclo de vida | Pilares, ciclo de vida de un proyecto y Python en ciencia de datos | 2 |
| 1.3 · Convenciones y reproducibilidad | Vocabulario, formato de entrega y reglas para resultados reproducibles | 1 |
| 1.4 · NumPy | Arrays, indexación, máscaras, estadísticas, aleatoriedad y broadcasting | 8 |
| 1.5 · Pandas | Series, DataFrames, filtrado, groupby, joins y reshaping | 8 |
| 1.6 · SQL y bases de datos | SELECT, agregación, JOINs, SQLite + Pandas y buenas prácticas | 8 |
| 1.7 · Parquet, Polars y DuckDB | Datos a escala: formato columnar y motores analíticos modernos | 4 |
| Total | 34 |
Reparto semanal orientativo
| Semanas | Contenido | Horas | Hito orientativo |
|---|---|---|---|
| 1–2 | Bloque conceptual: 1.1 (con la demo de destino), 1.2 y 1.3 | 6 | Ver el primer modelo entrenado en directo, entregar 01_tipos_aprendizaje.py y documentar el entorno |
| 3–4 | 1.4 NumPy | 8 | Entregar 02_numpy.py con interpretación de resultados |
| 5 | 1.5 Pandas (primera parte) | 4 | Inspeccionar, seleccionar y limpiar la tabla de TechShop |
| 6 | 1.5 Pandas (cierre) + comienzo de 1.6 SQL | 4 | Entregar 03_pandas.py y preparar la primera consulta |
| 7 | 1.6 SQL y bases de datos | 8 | Completar consultas, relaciones y comprobaciones con 04_sql.py |
| 8 | 1.7 Parquet, Polars y DuckDB + integración final | 4 | Entregar 05_datos_a_escala.py y preparar 06_integracion_ud1.py |
El reparto es orientativo para organizar las sesiones, no para seleccionar o eliminar contenidos. La semana 6 funciona como transición: se cierra Pandas y se arranca SQL sin duplicar horas.
La práctica final 06_integracion_ud1.py se inicia durante la semana 8 dentro
de las cuatro horas de integración y cierre. El trabajo autónomo, cuando se
indique, completa la práctica, pero no sustituye contenidos de la unidad. Integra el
mismo caso TechShop de los productos anteriores; no añade una herramienta nueva,
sino que comprueba que el alumnado sabe justificar y conectar el uso de NumPy,
Pandas y SQL.
Cómo trabajamos
- Formato de entrega: cuadernos marimo (no Jupyter), con celdas que ejecutan de forma reactiva y una sección final de conclusiones.
- Herramientas: Python 3.14 con
uv, VS Code y Git/GitHub. Si aún no las tienes preparadas, sigue las páginas comunes: Entorno de trabajo, VS Code, Cuadernos marimo, Git y GitHub y uv. - Regla del curso: todo ejemplo y toda práctica deben poder ejecutarse y mostrar su salida esperada. Si algo no funciona en tu equipo, el problema es reproducible y se corrige; no se entrega código "que a mí me funciona".
Productos evaluables
A lo largo de la unidad entregarás seis cuadernos marimo, uno por bloque, siempre ejecutados y con su «Salida esperada», interpretación de los resultados y una conclusión final:
| Cuaderno | Capítulo(s) | Qué entregas |
|---|---|---|
01_tipos_aprendizaje.py |
1.1–1.3 | Conceptos: definiciones de IA/ML/DL, clasificación de problemas y reglas de reproducibilidad. Se crea en 1.1 y se amplía en 1.2 y 1.3 |
02_numpy.py |
1.4 | Transformar y resumir una tabla de ventas con arrays, máscaras y broadcasting |
03_pandas.py |
1.5 | Cargar, limpiar y explorar el CSV de TechShop |
04_sql.py |
1.6 | Consultar y combinar las tablas de TechShop en SQLite y volcar el resultado a Pandas |
05_datos_a_escala.py |
1.7 | Parquet, Polars y DuckDB sobre un dataset a escala |
06_integracion_ud1.py |
Final | Integrar NumPy + Pandas + SQL sobre el mismo caso |
La práctica final 06_integracion_ud1.py no añade una herramienta nueva, sino
que comprueba que sabes justificar y conectar el uso de las tres. Además debe:
- observar y explicar las formas, tipos, filas no emparejadas y totales;
- justificar en qué paso usas SQL, Pandas o NumPy y por qué;
- comprobar cardinalidades, faltantes y resultados equivalentes entre pasos;
- documentar los errores encontrados, las decisiones y una conclusión final.
Cada capítulo concreta sus objetivos, su ejemplo guiado y su práctica.
Siguiente paso
Empieza por 1.1 · IA y Aprendizaje Automático.