1.6 · SQL y bases de datos
Objetivos. Al terminar este capítulo podrás: explicar qué es una base de
datos relacional; escribir consultas SELECT con filtros, agregaciones y
GROUP BY; combinar tablas con JOIN; conectar Python con SQLite; pasar
resultados a Pandas; y aplicar buenas prácticas de seguridad (consultas
parametrizadas).
Evidencia de logro. Crearás la base de datos de TechShop en SQLite, la consultarás con SQL (filtros, agregaciones y JOINs) y volcarás los resultados a un DataFrame de Pandas.
Contexto y motivación
Cuando los datos viven en una base de datos, lo más eficiente es consultarla con SQL y traer a Python solo el resultado que necesitas, en lugar de cargar tablas enteras. Si tienes 100 000 pedidos y solo quieres el total por ciudad, es absurdo traer las 100 000 filas a Python para sumarlas: le pides a la base de datos que sume y te devuelva 10 filas.
SQL es además un idioma común: la misma lógica de SELECT, GROUP BY y
JOIN se aplica en SQLite, PostgreSQL, MySQL, Oracle… Aprenderlo una vez te
sirve para cualquier motor.
En el curso usamos SQLite porque no necesita servidor: es un archivo (o una base en memoria) y viene incluido en Python. Para ver y tocar las bases, puedes usar DBeaver, DB Browser for SQLite o SQLiteStudio (todas con versión gratuita).
Vocabulario
| Término | Significado |
|---|---|
| Tabla | Estructura con filas y columnas |
| Clave primaria (PK) | Columna que identifica de forma única cada fila |
| Clave foránea (FK) | Columna que referencia la PK de otra tabla |
| Consulta | Instrucción que pide datos (SELECT) o los modifica (INSERT, UPDATE, DELETE) |
| JOIN | Combinación de dos tablas por una clave común |
| Cursor | Objeto que ejecuta consultas y recorre resultados en Python |
Prerrequisitos
Haber trabajado 1.5 · Pandas (usaremos read_sql_query).
Ruta de estudio
El núcleo obligatorio es el modelo relacional, SELECT, filtros,
agregaciones, GROUP BY, JOIN, parámetros, SQLite y la integración con
Pandas. Las subconsultas, CTE, funciones de ventana, vistas, índices y
transacciones más detalladas quedan como ampliación guiada cuando el
recorrido básico ya funciona.
Orden de los ejemplos
La sección 2 crea la base de pruebas y las secciones siguientes la consultan y modifican. Ejecuta la página de arriba abajo; si pruebas un fragmento aislado, copia también el bloque de preparación de la sección 2.
1. Fundamentos relacionales
Una base de datos relacional organiza la información en tablas relacionadas
por claves. La idea clave es no repetir datos: guardamos cada cliente una
sola vez y cada pedido lo referencia por su id_cliente.
clientes(id_cliente, nombre, ciudad, segmento)
productos(id_producto, nombre, categoria, precio)
pedidos(id_pedido, id_cliente, id_producto, unidades, importe, fecha)
id_clientees la clave primaria declientes: identifica cada cliente de forma única.id_clientedentro depedidoses una clave foránea: apunta al cliente dueño del pedido.
¿Por qué no poner todo en una única tabla gigante? Porque repetirías el nombre y la ciudad del cliente en cada pedido: ocupa más, y si el cliente cambia de ciudad tendrías que actualizar decenas de filas (y seguro que alguna se te olvida). Separar en tablas y relacionarlas evita esa duplicación: es el principio de normalización.
2. Preparar el banco de pruebas
Las consultas de esta sección y de las dos siguientes usan siempre las mismas tres tablas de TechShop. Creamos la base antes de consultarla: SQLite viene en la biblioteca estándar y usamos una base en memoria, para que el cuaderno se pueda ejecutar varias veces sin dejar archivos ni datos antiguos:
import sqlite3

con = sqlite3.connect(":memory:")
cur = con.cursor()

cur.executescript("""
PRAGMA foreign_keys = ON;
CREATE TABLE clientes (
    id_cliente INTEGER PRIMARY KEY,
    nombre TEXT NOT NULL,
    ciudad TEXT,
    segmento TEXT
);
CREATE TABLE productos (
    id_producto INTEGER PRIMARY KEY,
    nombre TEXT NOT NULL,
    categoria TEXT,
    precio REAL NOT NULL
);
CREATE TABLE pedidos (
    id_pedido INTEGER PRIMARY KEY,
    id_cliente INTEGER NOT NULL,
    id_producto INTEGER NOT NULL,
    unidades INTEGER NOT NULL,
    importe REAL NOT NULL,
    fecha TEXT NOT NULL,
    FOREIGN KEY (id_cliente) REFERENCES clientes (id_cliente),
    FOREIGN KEY (id_producto) REFERENCES productos (id_producto)
);
INSERT INTO clientes VALUES
    (1, 'Ana', 'Sevilla', 'VIP'),
    (2, 'Luis', 'Málaga', 'normal'),
    (3, 'Marta', 'Sevilla', 'normal');
INSERT INTO productos VALUES
    (101, 'raton', 'periferico', 60.0),
    (102, 'teclado', 'periferico', 80.0),
    (103, 'monitor', 'pantalla', 300.0);
INSERT INTO pedidos VALUES
    (101, 1, 101, 2, 120.0, '2026-09-01'),
    (102, 1, 102, 1, 80.0, '2026-09-01'),
    (103, 2, 103, 1, 300.0, '2026-09-02'),
    (104, 3, 101, 1, 45.0, '2026-09-03');
""")
con.commit()   # guarda los cambios
Este bloque no imprime nada: su efecto observable es la base en memoria
quedando preparada, con las tablas clientes, productos y pedidos
(3 clientes, 3 productos y 4 pedidos). No genera un archivo. Puedes
comprobarlo con la primera consulta de la sección 3.
Tres ideas importantes de este bloque: connect abre (o crea) la base,
cursor es el objeto que ejecuta las consultas, y commit() guarda los
cambios (sin él, los INSERT/UPDATE/DELETE se pierden al cerrar). En las
secciones siguientes ejecutaremos las consultas con cur.execute(...) y
leeremos los resultados con fetchall(); la sección 6 detalla cada paso.
3. SELECT, WHERE y orden
Las consultas SQL de esta sección, la 4 y la 5 se ejecutan sobre el banco de
pruebas con el cursor de la sección 2; el resultado que muestran es el que
devuelve cur.execute(consulta).fetchall() (una tupla por fila). Por ejemplo,
la primera consulta se ejecuta así:
filas = cur.execute("""
    SELECT nombre, ciudad
    FROM clientes
    WHERE segmento = 'normal'
    ORDER BY nombre
""").fetchall()
print(filas)
Salida esperada:
La consulta básica tiene esta forma:
Salida esperada:
Leamos la consulta como una frase: "selecciona nombre y ciudad de clientes donde el segmento sea normal, ordenado por nombre". SQL está pensado para leerse casi en lenguaje natural.
WHEREfiltra filas (antes de ordenar o agrupar).ORDER BYordena (conDESCdescendente).LIMIT nse queda con las primeras:
Salida esperada:
4. Agregación y GROUP BY
Las funciones de agregación resumen muchas filas en una: COUNT, SUM,
AVG, MIN, MAX.
GROUP BY aplica la agregación por grupo:
SELECT ciudad, COUNT(*) AS pedidos, SUM(p.importe) AS total
FROM clientes c
JOIN pedidos p ON c.id_cliente = p.id_cliente
GROUP BY ciudad
ORDER BY ciudad;
Salida esperada:
Esta consulta adelanta un JOIN, que se explica en la sección 5: de momento
basta con saber que une cada pedido con el cliente que lo hizo. clientes c y
pedidos p dan a cada tabla un alias corto, de modo que p.importe
significa «la columna importe de la tabla pedidos».
Aquí GROUP BY ciudad divide las filas en grupos (Málaga y Sevilla) y las
agregaciones se calculan dentro de cada grupo: Sevilla tiene 3 pedidos
que suman 120 + 80 + 45 = 245. El AS pedidos y AS total ponen nombre a
las columnas calculadas.
HAVING filtra después de agrupar (a WHERE no se le puede pedir que filtre
por un agregado):
SELECT id_cliente, SUM(importe) AS total
FROM pedidos
GROUP BY id_cliente
HAVING SUM(importe) > 100
ORDER BY id_cliente;
Salida esperada:
WHERE vs HAVING
WHERE filtra filas antes de agrupar; HAVING filtra grupos después.
Regla rápida: lo que usa SUM/AVG/COUNT va en HAVING; lo que usa
columnas normales va en WHERE.
5. JOIN: combinar tablas
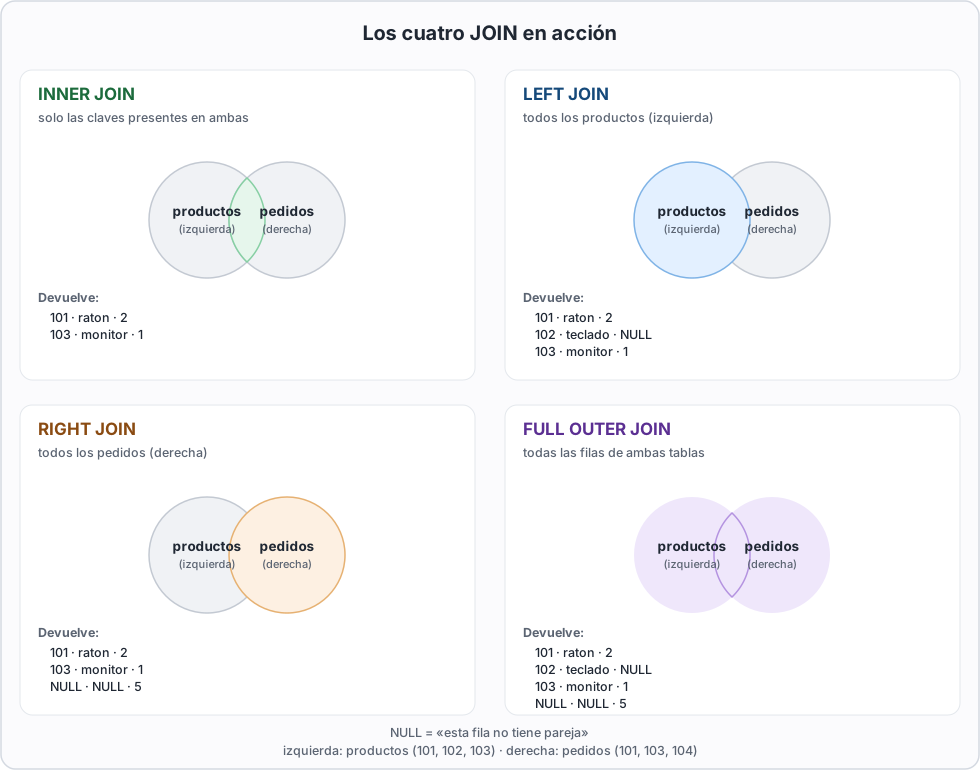
Un JOIN empareja filas de dos tablas por una clave común. Es la operación
que distingue a las bases relacionales: te permite reconstruir la información
que repartiste en varias tablas. Para aislar la cardinalidad usaremos dos tablas
demo, distintas de las tablas de TechShop:
productos_demo: (101,'raton'), (102,'teclado'), (103,'monitor')
pedidos_demo:   (101, 2),       (103, 1),        (104, 5)
Créalas en la misma conexión, con cur.executescript("""...""") como en la
sección 2 (el bloque siguiente es el SQL que va dentro):
DROP TABLE IF EXISTS productos_demo;
DROP TABLE IF EXISTS pedidos_demo;
CREATE TEMP TABLE productos_demo (id INTEGER PRIMARY KEY, nombre TEXT);
CREATE TEMP TABLE pedidos_demo (id INTEGER, unidades INTEGER);
INSERT INTO productos_demo VALUES
    (101, 'raton'), (102, 'teclado'), (103, 'monitor');
INSERT INTO pedidos_demo VALUES
    (101, 2), (103, 1), (104, 5);
| JOIN | Devuelve |
|---|---|
| INNER | Solo las claves presentes en ambas |
| LEFT | Todas las filas de la izquierda (+ NULL si no hay pareja) |
| RIGHT | Todas las filas de la derecha (+ NULL si no hay pareja) |
| FULL OUTER | Todas las filas de ambas |
-- INNER
SELECT p.id, p.nombre, d.unidades
FROM productos_demo p JOIN pedidos_demo d ON p.id = d.id
ORDER BY p.id;
-- (101,'raton',2), (103,'monitor',1)

-- LEFT: todos los productos, tengan o no pedido
SELECT p.id, p.nombre, d.unidades
FROM productos_demo p LEFT JOIN pedidos_demo d ON p.id = d.id
ORDER BY p.id;
-- (101,'raton',2), (102,'teclado',NULL), (103,'monitor',1)

-- RIGHT: todos los pedidos, tengan o no producto
SELECT p.id, p.nombre, d.unidades
FROM productos_demo p RIGHT JOIN pedidos_demo d ON p.id = d.id
ORDER BY d.id;

-- FULL OUTER: todas las filas de ambas tablas
SELECT p.id, p.nombre, d.unidades
FROM productos_demo p FULL OUTER JOIN pedidos_demo d ON p.id = d.id
ORDER BY COALESCE(p.id, d.id);
Salida esperada (RIGHT y FULL):
RIGHT:
  (101, 'raton', 2)
  (103, 'monitor', 1)
  (NULL, NULL, 5)      -- el pedido 104 no tiene producto
FULL:
  (101, 'raton', 2)
  (102, 'teclado', NULL)
  (103, 'monitor', 1)
  (NULL, NULL, 5)
Fíjate en el NULL: es la marca de "aquí no había pareja". En el LEFT, el
teclado (sin pedido) aparece con NULL en unidades; en el RIGHT, el pedido
104 (sin producto) aparece con NULL en nombre. Cuando ejecutes estas
consultas desde Python, sqlite3 devuelve cada NULL como None:
(None, None, 5).
SQLite moderno lo soporta
SQLite (versión 3.39 en adelante) admite RIGHT JOIN y FULL OUTER JOIN.
En el curso usamos SQLite 3.50, así que puedes usarlos; INNER y LEFT
siguen siendo los más habituales en el día a día.
COALESCE(valor, sustituto) convierte los NULL en un valor con sentido:
SELECT c.nombre, COALESCE(p.id_pedido, -1) AS id_pedido
FROM clientes c LEFT JOIN pedidos p ON c.id_cliente = p.id_cliente
ORDER BY c.id_cliente, p.id_pedido;
Salida esperada:
Los cuatro pedidos tienen pareja, así que aquí no aparece ningún -1. Para ver
COALESCE en acción con un hueco, añade un cliente sin pedidos:
cur.execute(
    "INSERT INTO clientes (nombre, ciudad, segmento) VALUES (?, ?, ?)",
    ("Nora", "Granada", "VIP"),
)
con.commit()
print(cur.execute("""
    SELECT c.nombre, COALESCE(p.id_pedido, -1) AS id_pedido
    FROM clientes c LEFT JOIN pedidos p ON c.id_cliente = p.id_cliente
    ORDER BY c.id_cliente, p.id_pedido
""").fetchall())
Salida esperada:
Nora no tiene pedidos: su fila muestra -1 en vez de NULL.
6. Python + SQLite: ejecutar y recorrer
Las secciones 3 a 5 ya usaron cur.execute(...) y fetchall() sobre el banco
de pruebas de la sección 2. Esta sección detalla el vocabulario de la API de
sqlite3 que has estado usando sin parar a mirarla.
6.1 Insertar con parámetros (seguro)
cur.execute(
    "INSERT INTO clientes (nombre, ciudad, segmento) VALUES (?, ?, ?)",
    ("Iker", "Bilbao", "normal"),
)
con.commit()
fila = cur.execute("SELECT * FROM clientes WHERE nombre = ?", ("Iker",)).fetchone()
print(fila)
Salida esperada:
Los ? son marcadores de posición: le decimos a SQLite "aquí irá un
valor" y se lo pasamos aparte en una tupla. Verás al final por qué esto es
tan importante para la seguridad.
6.2 Recorrer resultados: fetchone, fetchall, fetchmany
print(cur.execute("SELECT nombre FROM clientes ORDER BY id_cliente LIMIT 2").fetchall())
cur.execute("SELECT nombre FROM clientes ORDER BY id_cliente")
print(cur.fetchmany(2))   # el cursor recuerda la posición
print(cur.fetchmany(2))
Salida esperada:
El cursor tiene una posición: cada fetchmany continúa donde se quedó.
Por eso execute() y fetch*() van separados: primero ejecutas, luego
"lees" los resultados poco a poco. fetchone devuelve una fila, fetchall
todas, y fetchmany(n) de n en n (útil para resultados enormes que no caben
en memoria).
6.3 Context manager de transacciones
Salida esperada:
El with confirma la transacción al salir si todo va bien y la revierte si
hay una excepción. No cierra la conexión: la conexión sigue disponible
para las celdas siguientes; al trabajar con una base en memoria no la
cierres hasta terminar el cuaderno.
6.4 Transacción y conexión son cosas distintas
Conviene separar dos responsabilidades que a menudo se confunden:
commit()confirma los cambios de la transacción.rollback()revierte los cambios pendientes.close()cierra la conexión y ya no permite usarla.
El objeto Connection de sqlite3 puede usarse con with, pero su gestor de
contexto solo controla la transacción: al salir hace commit() si el bloque ha
terminado correctamente y rollback() si ha ocurrido una excepción. La
documentación oficial indica expresamente que ese with no cierra la
conexión. Por eso no debemos interpretar:
como "abrir y cerrar una conexión". Significa "delimitar una transacción".
Para cerrar una conexión hay que llamar explícitamente a close():
conexion_prueba = sqlite3.connect(":memory:")
conexion_prueba.close()
print("Conexión de prueba cerrada")
Salida esperada:
Después de close(), cualquier consulta con conexion_prueba produce un error
porque esa conexión ya no es utilizable. En este capítulo no cerramos con en
este punto: las consultas siguientes la necesitan. No uses close() como
sustituto de commit():
cerrar una conexión con cambios pendientes puede perderlos según el modo de
control de transacciones.
En un script, cuando termina el proceso el sistema operativo libera sus
recursos, pero no conviene usar el final del programa como estrategia de cierre:
no queda claro dónde se confirma la última transacción y una conexión olvidada
puede emitir un ResourceWarning en Python 3.13 o posterior. Haz siempre
explícitos commit() y close() cuando seas responsable de la conexión.
Qué ocurre en un cuaderno marimo
Un cuaderno marimo mantiene vivo su kernel entre celdas. Si creas con en
una celda y en otra escribes with con:, al terminar esa celda se confirma o
revierte la transacción, pero con sigue abierta y puede utilizarse en las
celdas siguientes. Esto es lo que necesitamos en este capítulo, porque las
consultas posteriores reutilizan la misma base en memoria.
Cuando termines todas las consultas, ejecuta la celda de cierre que aparece
al final de este capítulo. No la ejecutes antes: después de close() tendrás
que crear otra conexión y, si usas ":memory:", también tendrás que
reconstruir las tablas y los datos.
6.5 Cerrar automáticamente con contextlib.closing
Si quieres que la conexión se cierre al salir de un bloque, usa
contextlib.closing. Como closing() solo llama a close(), lo combinamos con
el with de la conexión para conservar también el commit/rollback:
from contextlib import closing
import sqlite3

with closing(sqlite3.connect(":memory:")) as conexion_corta:
    with conexion_corta:
        conexion_corta.execute("CREATE TABLE datos (valor INTEGER)")
        conexion_corta.execute("INSERT INTO datos VALUES (?)", (8,))
        print(conexion_corta.execute("SELECT * FROM datos").fetchone())

# Al salir del bloque exterior, closing() ya ha llamado a close().
Salida esperada:
El bloque interior gestiona la transacción y el exterior garantiza el cierre.
Este patrón es apropiado para una conexión que solo se necesita durante un
bloque. En marimo, donde varias celdas necesitan la misma conexión, suele ser
mejor mantener con abierta y cerrarla en una celda final.
Consulta la documentación oficial del gestor de contexto de
sqlite3
y la referencia de contextlib.closing
si necesitas otros patrones de gestión de recursos.
7. SQL + Pandas
Pandas lee directamente el resultado de una consulta:
import pandas as pd

df_clientes = pd.read_sql_query("SELECT * FROM clientes", con)
print(df_clientes)

resumen = pd.read_sql_query("""
    SELECT c.ciudad, COUNT(*) AS pedidos, ROUND(AVG(p.importe), 1) AS importe_medio
    FROM clientes c JOIN pedidos p ON c.id_cliente = p.id_cliente
    GROUP BY c.ciudad
""", con)
print(resumen)
Salida esperada:
   id_cliente nombre   ciudad segmento
0           1    Ana  Sevilla      VIP
1           2   Luis   Málaga   normal
2           3  Marta  Sevilla   normal
3           4   Nora  Granada      VIP
4           5   Iker   Bilbao   normal
    ciudad  pedidos  importe_medio
0   Málaga        1          300.0
1  Sevilla        3           81.7
El resumen recoge los cuatro pedidos de la tabla de pedidos. Fíjate en quién
no aparece: Nora, que añadimos en la sección 5 para ver COALESCE, y
también Iker, que tiene datos pero ningún pedido. Los dos quedan fuera porque
un INNER JOIN solo conserva las filas que coinciden en ambos lados.
read_sql_query es el puente perfecto: dejas que SQL haga el trabajo
pesado (filtrar y agregar) y recibes un DataFrame listo para visualizar o
seguir transformando con Pandas.
También puedes escribir un DataFrame a SQL con df.to_sql("tabla", con,
if_exists="replace", index=False). Ojo: si creas la tabla así, define tú la
clave primaria, porque to_sql no la crea automáticamente.
8. ¿Agregar en SQL o en Pandas?
Regla general: filtra y agrega en la base de datos (trae menos datos a Python); transforma y visualiza en Pandas:
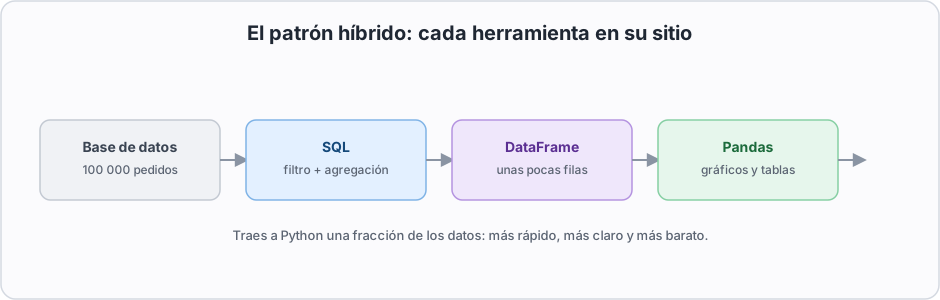
La base de datos hace el trabajo pesado (filtrar y agregar sobre 100 000 pedidos) y devuelve unas pocas filas; Pandas recibe un DataFrame pequeño y se encarga de lo que le toca: gráficos, tablas y la conclusión.
Ejemplo: en vez de traer 100 000 pedidos a Pandas para sumarlos, pides a SQL el total por ciudad (unas pocas filas) y luego pintas el gráfico con Pandas. Trabajas con una fracción de los datos y todo es más rápido y claro.
9. Percentiles, cuartiles, IQR y Z-score
SQLite no trae percentiles integrados; los calculamos cómodamente en Pandas:
importes = pd.read_sql_query("SELECT importe FROM pedidos", con)["importe"]
print(importes.quantile([0.25, 0.5, 0.75]).round(1))

q1 = importes.quantile(0.25)
q3 = importes.quantile(0.75)
iqr = q3 - q1
print("Q1 =", q1, "· Q3 =", q3, "· IQR =", iqr)
Salida esperada:
Interpretación:
- Percentil
p: valor que deja por debajo elp% de los datos. El percentil 25 es 71,25 (la primera línea lo muestra redondeado a 71,2): el 25 % de los importes están por debajo. Con solo cuatro importes, pandas interpola entre los valores reales, por eso sale un número que no aparece en la tabla. - Cuartiles: percentiles 25, 50 (mediana) y 75.
- IQR (rango intercuartílico) = Q3 − Q1: mide la dispersión central (ignora los extremos).
- Un outlier (valor atípico) suele definirse como el que queda fuera de
[Q1 − 1.5·IQR, Q3 + 1.5·IQR]. Con estos datos no hay outliers; si los hubiera, antes de borrarlos hay que investigarlos (¿error de captura o caso real extremo?).
9.1 Z-score: distancia respecto a la media
El Z-score expresa cuántas desviaciones típicas se separa cada valor de la media. Para una observación \(x\), se calcula como
Como regla orientativa, se investigan los valores con |z| > 3. En un dataset
pequeño esta regla tiene poca potencia, así que no sustituye al conocimiento
del dominio ni a la revisión con IQR:
z_scores = (
        (importes - importes.mean()) / importes.std(ddof=0)
).round(2)
print("z-scores:", z_scores.to_list())
print("outliers |z| > 3:", int((z_scores.abs() > 3).sum()))
Salida esperada:
El ddof=0 hace explícita la desviación típica de estos cuatro datos
observados. Si trabajas con una muestra para inferencia, el tratamiento de
la desviación y la incertidumbre se retomará en la Unidad 3.
10. Subconsultas, CTEs y window functions
Subconsulta = una consulta dentro de otra. Por ejemplo, clientes que gastan más que la media:
SELECT c.nombre, SUM(p.importe) AS total
FROM clientes c JOIN pedidos p ON c.id_cliente = p.id_cliente
GROUP BY c.id_cliente, c.nombre
HAVING SUM(p.importe) > (SELECT AVG(importe) FROM pedidos);
Salida esperada:
La subconsulta (SELECT AVG(importe) FROM pedidos) calcula un único valor
(la media = 136,25) y el HAVING lo usa como umbral. Es la forma de
comparar "contra un número calculado" sin saberlo de antemano.
CTE (WITH) = subconsulta con nombre, más legible:
WITH por_cliente AS (
    SELECT id_cliente, SUM(importe) AS total
    FROM pedidos GROUP BY id_cliente
)
SELECT c.nombre, pc.total
FROM por_cliente pc JOIN clientes c ON c.id_cliente = pc.id_cliente
ORDER BY pc.total DESC;
Salida esperada:
La CTE es como "guardar un resultado intermedio con nombre" para usarlo después. Se lee mejor que una subconsulta anidada cuando hay varios pasos.
Window function = agregado que se calcula por fila sin colapsar la tabla:
Salida esperada:
A diferencia de GROUP BY (que colapsa filas), OVER (ORDER BY ...)
calcula el ranking para cada fila sin agrupar: obtienes el "puesto" de
cada pedido por importe.
Vistas = consultas guardadas con nombre que se reutilizan:
CREATE VIEW v_resumen AS
SELECT id_cliente, SUM(importe) AS total
FROM pedidos GROUP BY id_cliente;

SELECT * FROM v_resumen ORDER BY total DESC;
Salida esperada:
CTE vs vista
La CTE vive solo dentro de su consulta; la vista se guarda y puede usarse en muchas consultas. Usa CTE para pasos intermedios de una consulta y vistas para resúmenes recurrentes.
11. Buenas prácticas
11.1 Prevención de inyección SQL
Nunca concatenes valores del usuario dentro del SQL:
def buscar(nombre):
    # PELIGRO: si nombre = "' OR '1'='1", devuelve todas las filas.
    return con.execute(f"SELECT * FROM clientes WHERE nombre = '{nombre}' ORDER BY id_cliente").fetchall()

print(buscar("' OR '1'='1"))   # ¡fuga de datos!
Salida esperada:
[(1, 'Ana', 'Sevilla', 'VIP'), (2, 'Luis', 'Málaga', 'normal'), (3, 'Marta', 'Sevilla', 'normal'), (4, 'Nora', 'Granada', 'VIP'), (5, 'Iker', 'Bilbao', 'normal')]
¿Qué ha pasado? Al concatenar, el texto ' OR '1'='1 se convierte en
parte de la consulta: WHERE nombre = '' OR '1'='1'. Como '1'='1'
siempre es verdad, la consulta devuelve todas las filas. Es la base del
famoso ataque de inyección SQL.
Con la consulta parametrizada (?) el valor se trata como dato, no como
código:
def buscar_seguro(nombre):
    return con.execute("SELECT * FROM clientes WHERE nombre = ? ORDER BY id_cliente", (nombre,)).fetchall()

print(buscar_seguro("' OR '1'='1"))   # no devuelve nada: no existe ese nombre
Salida esperada:
Al usar ?, SQLite entiende que ' OR '1'='1 es un texto a comparar,
no código. Como ningún cliente se llama así, no devuelve nada.
Siempre parametriza
Toda entrada del usuario o de un archivo va por parámetros (?), nunca
concatenada. Es la regla de seguridad número uno con bases de datos, y es un
hábito que hay que adquirir desde el primer día.
11.2 Índices y credenciales
- Índices: aceleran búsquedas sobre columnas muy consultadas:
CREATE INDEX idx_pedidos_cliente ON pedidos(id_cliente); - Credenciales: nunca escribas contraseñas en el código; usa variables de entorno (lo aplicarás al conectar con otros motores en el módulo de Programación de IA).
¿Y Oracle/MariaDB/SQLAlchemy?
Conectar con otros motores (Oracle, MariaDB…) y usar un ORM
(SQLModel/SQLAlchemy) para aplicaciones corresponde al módulo de
Programación de IA. Aquí nos quedamos en SQLite y SQL puro, que es la
base común de todos.
11.3 Cierre final de la conexión
Cuando ya no queden consultas que ejecutar, confirma los cambios pendientes y
cierra la conexión. En un cuaderno marimo, esta debe ser la última celda que
use con:
Salida esperada:
Errores frecuentes
- Filtrar agregados con
WHEREen vez deHAVING. - Olvidar la condición
ONdelJOIN(o unir por la columna equivocada). - Concatenar valores en el SQL (inyección) en lugar de parametrizar.
- Olvidar
con.commit()trasINSERT/UPDATE/DELETE. - Pensar que
with con:cierra la conexión; solo confirma o revierte la transacción. Cierra concon.close()al terminar. - Traer tablas enteras a Pandas cuando SQL podía agregarlas antes.
Práctica de transferencia
Crea una base SQLite en memoria con este esquema (tres tablas):
productos(id_producto, nombre, categoria, precio)
clientes(id_cliente, nombre, ciudad)
pedidos(id_pedido, id_cliente, id_producto, unidades, fecha)
- Inserta al menos 4 productos, 4 clientes y 6 pedidos inventados.
- Escribe una consulta que devuelva el importe total (unidades × precio) por cliente, ordenado de mayor a menor.
- Escribe una consulta con
LEFT JOINque muestre todos los productos y, si no tienen pedidos, muestre 0 vendidas (COALESCE). - Repite el cálculo del punto 2 pero agregando en SQL y volcando a Pandas
con
read_sql_query. - Comprueba que un
GROUP BY ... HAVINGencuentra los clientes con más de un pedido.
Qué debes comprobar: en el punto 2, que la suma de los totales por cliente
coincide con el total de todos los pedidos; en el 3, que aparecen todos los
productos (tantas filas como productos insertaste) y que los que no se han
vendido muestran 0, no None.
Producto evaluable
Cuaderno 04_sql.py con:
- El esquema y los datos del ejercicio anterior (celdas
executescript). - Cada consulta en una celda, con su resultado y una celda Markdown que lo interprete.
- Una celda final que demuestre la diferencia entre una consulta vulnerable y su versión parametrizada.
Formato de entrega: cuaderno marimo ejecutado, con conclusiones al final.
Resumen y referencia rápida
| Tarea | Sintaxis |
|---|---|
| Consultar | SELECT cols FROM tabla WHERE cond ORDER BY col LIMIT n |
| Agregar | COUNT, SUM, AVG, MIN, MAX + GROUP BY |
| Filtrar grupos | HAVING |
| Combinar | JOIN/LEFT JOIN/RIGHT JOIN/FULL OUTER JOIN + ON |
| Tratar NULL | COALESCE(v, sustituto) |
| Python | sqlite3.connect, cursor, execute con ?, fetch* |
| Transacciones y cierre | with con para commit/rollback; con.close() para cerrar; closing() para automatizar el cierre |
| Pandas | read_sql_query, to_sql |
| Avanzado | subconsultas, CTE (WITH), window functions, vistas |
| Seguridad | consultas parametrizadas, índices, credenciales por entorno |
Siguiente: 1.7 · Parquet, Polars y DuckDB.